26 October 2026 · 9 min de lecture
La valeur de l’IA n’est pas dans l’organigramme. Elle est dans le bouton d’arrêt.
Si vous voulez faire bouger le débit, le rendement et les arrêts, attribuez les droits de décision comme vous le faites pour la sécurité, la qualité et la mise en production.
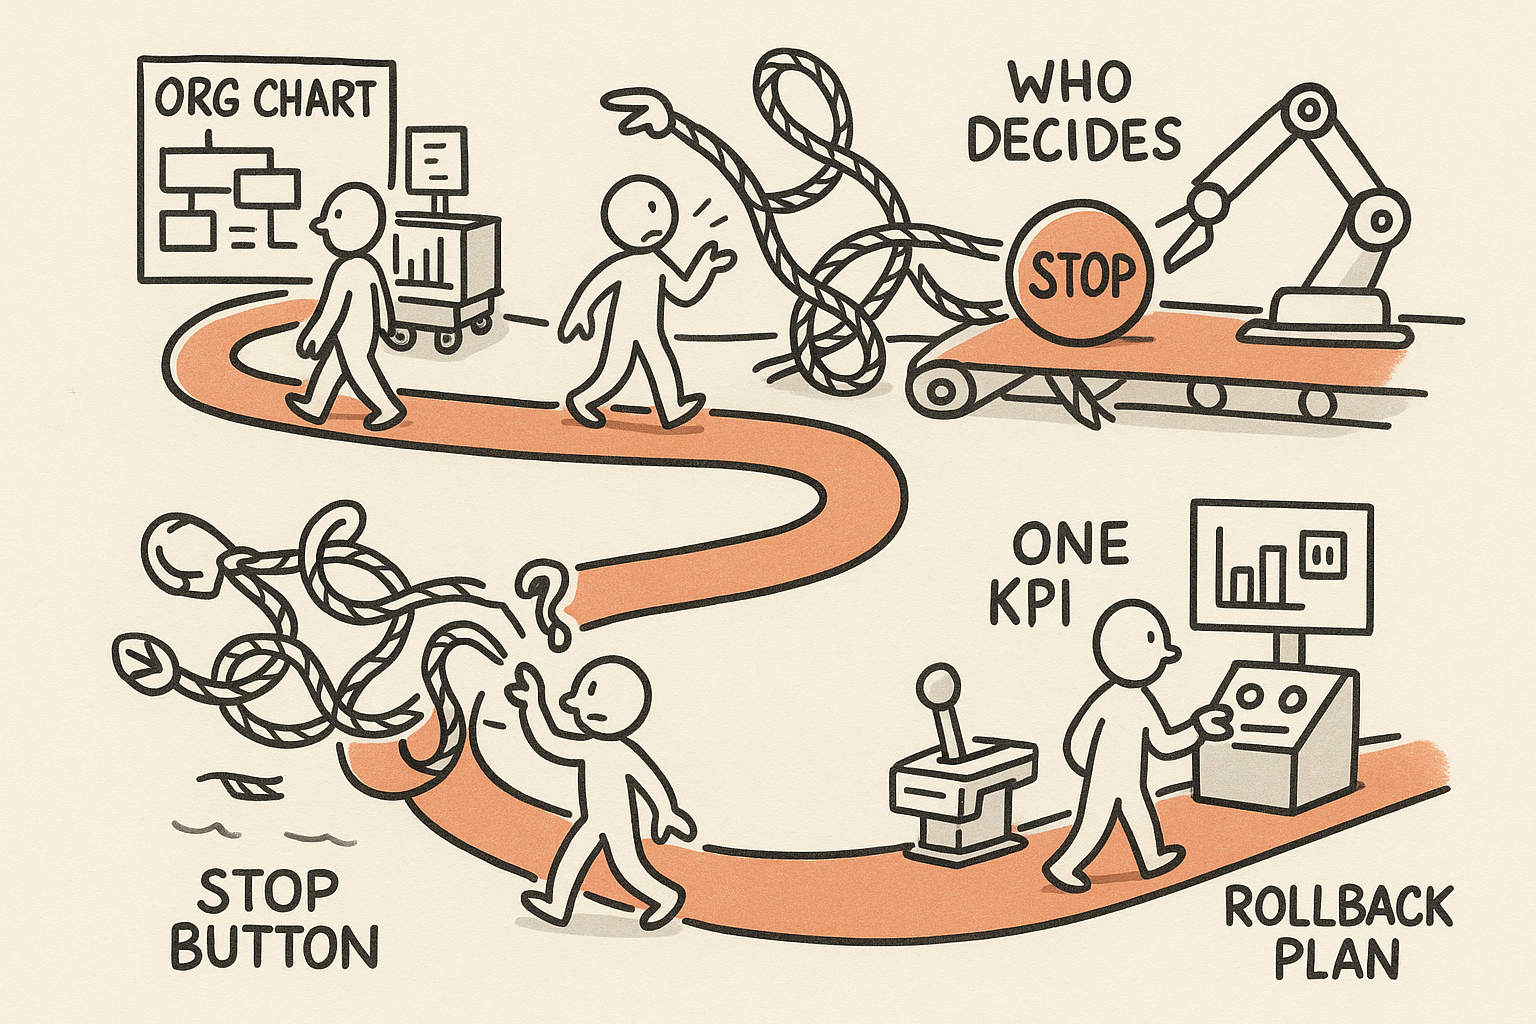
La plupart des programmes d’IA (intelligence artificielle) que j’ai vus échouent toujours selon le même scénario. Beaucoup d’activité visible : on crée une équipe IA centrale, un comité de gouvernance, un dashboard. On enchaîne les pilotes. On écrit des principes. Les coûts montent. Le débit ne bouge pas.
Ce mode d’échec ne vient pas de la qualité des modèles. Il vient de la responsabilité. La valeur de l’IA ne se trouve pas dans l’organigramme. Elle se joue sur trois points : qui détient la décision, qui détient la métrique, et qui détient le bouton d’arrêt.
Quand je dirigeais des opérations dans l’électrification et le stockage d’énergie, j’avais la responsabilité de l’ingénierie, de la production, de la supply chain, du service et des opérations. À ce poste, on comprend vite qu’une amélioration « intelligente » qu’on ne peut pas annuler n’est pas une innovation. C’est un risque opérationnel. Et si personne ne peut répondre à « qui décide ? » en une phrase, vous n’avez pas un système. Vous avez une mise en scène.
Mon point de vue est simple : si un cas d’usage d’IA touche une ligne, un process ou un workflow critique pour le client, il doit être traité comme n’importe quel changement en production. Mise en production. Contrôle. Mesure. Rollback. Autorité claire. Le reste est optionnel.
Le seul modèle opérationnel d’IA qui tient en période de retournement
Un retournement impose une discipline. Vous ne pouvez pas vous payer des structures parallèles qui ne déplacent pas la contrainte. Vous ne pouvez pas vivre avec une responsabilité floue. Et vous ne pouvez pas déployer fragile, puis passer des réunions à débattre de minutes d’arrêt non planifié.
En période de retournement, la question utile n’est pas : « que peut faire l’IA ? ». C’est : « quelles décisions, si on les prend plus vite ou mieux, feront bouger le débit, le rendement ou le besoin en fonds de roulement ce trimestre ? ». Ensuite, vous attribuez les droits de décision aussi fermement que vous attribuez la responsabilité d’un budget.
Quand je pilotais une business unit smart building avec une responsabilité P&L complète dans plusieurs pays, la même règle s’appliquait hors usine : si un produit connecté ou une fonctionnalité cloud n’avait pas un propriétaire clair pour la qualité, la mise en production et l’impact client, cela créait du bruit. Le bruit devient du churn. Le churn devient une pression sur la marge. L’IA ne fait pas exception. Elle échoue juste plus vite, parce qu’elle automatise la prise de décision.
Si vous voulez un cadrage qui tient sous pression, retenez celui-ci : l’IA est un changement de modèle opérationnel déguisé en projet logiciel.
Cinq droits de décision qui débloquent l’essentiel de la valeur
Dans l’industrie, j’ai constaté que la valeur de l’IA est généralement bloquée par un petit nombre de droits de décision. Pas vingt. Souvent trois à cinq. Voici ceux que j’exigerais, avec des noms en face, avant de financer un pilote de plus.
- Qui est propriétaire de la mise en production d’une IA sur une ligne ou un process donné ?
Ce n’est pas « l’équipe IA ». C’est le responsable opérationnel du process, avec un homologue technique clairement identifié. Si personne côté opérations ne peut valider une mise en production, vous ne passerez jamais à l’échelle. Si les opérations peuvent valider sans garde-fous techniques, vous mettez du risque en production.
- Qui peut modifier des consignes ou des recettes, et qui peut les annuler (rollback) ?
Si un modèle influence le contrôle, il faut un chemin de rollback dur, explicite. Si votre plan de rollback, c’est « on va monitorer et intervenir », vous n’avez pas de plan. Vous avez de l’espoir.
- Qui valide la qualité des données à la source (capteur, PLC, SCADA), et pas dans le cloud ?
En électronique de puissance et en automatisation industrielle, j’ai appris qu’une qualité en amont vaut mieux que des exploits en aval. Si un capteur dérive, votre modèle apprend des contre-vérités. La qualité des données est une responsabilité production, avec le support de l’ingénierie ; ce n’est pas un nettoyage a posteriori pour l’analytics.
- Qui porte le cost-of-poor-quality de bout en bout ?
Si la rebut, la retouche, les retours et le service sont répartis entre plusieurs fonctions, l’IA devient une machine à fabriquer des débats. Donnez le cost-of-poor-quality à un seul accountable owner, avec une définition unique. Vous pourrez alors décider si un cas d’usage mérite d’être mis en production.
- Qui décide qu’un modèle est « suffisamment bon » pour être mis en production, versus « agréable à avoir » ?
« Plus précis » n’est pas un indicateur business. Le « suffisamment bon » doit être défini en fonction des résultats opérationnels et du risque. En pratique, c’est une décision conjointe : les opérations portent le résultat, l’ingénierie porte le risque technique, la finance verrouille la définition.
Remarquez ce qui manque : un comité. Un comité peut donner un avis. Il ne peut pas posséder le bouton d’arrêt. Et en production, le bouton d’arrêt, c’est le cœur du métier.
Des métriques qui marchent (et celles qui fabriquent des réunions)
Les équipes IA adorent les métriques proxy : elles sont simples à produire. Accuracy. F1 score. AUC. Model confidence. Elles peuvent compter, mais ce n’est pas ce que les boards financent.
Les définitions de KPI qui résistent systématiquement au réel sont peu glamour, très opérationnelles, et « finance-grade ». Choisissez-en peu, et rendez-les auditables.
- Débit à la contrainte : le seul débit qui compte est celui du goulot. Si l’IA améliore une étape hors contrainte, c’est bien, mais ne prétendez pas avoir déplacé le système.
- Rendement et first-pass yield : distinguez le vrai rendement de celui masqué par la retouche. Si vous ne séparez pas les deux, vous optimiserez le mauvais comportement.
- Minutes d’arrêts non planifiés : suivez-les comme la sécurité. Définissez-les une fois. Appliquez la définition partout.
- Coût de rebut et de retouche : reliez-le au cost-of-poor-quality, pas à l’ego de l’ingénierie.
- Adhérence forecast-to-plan : en supply chain et en planification, la valeur n’est pas dans « une meilleure prévision ». Elle est dans moins de changements de planning, moins d’expéditions en urgence, moins de surprises.
La sélection compte moins que la propriété. Ces métriques doivent appartenir aux opérations, avec des définitions « finance-grade ». Pas une définition de slide. Une définition compatible avec la clôture comptable.
Contrôles de workflow : la partie ingrate qui rend l’IA réelle
J’ai reconstruit et fait grandir des organisations R&D, et j’ai porté la QA sur du hardware et du software. Le schéma est toujours le même : la fiabilité ne vient pas du talent seul. Elle vient du workflow. La livraison d’IA exige la même discipline.
Voici le minimum de control plane que je mettrais en place.
- Une file unique de cas d’usage, alignée sur les goulots.
Si chaque directeur d’usine et chaque fonction peut lancer un projet IA, vous allez vous noyer dans les pilotes. Une seule file. Une priorisation forcée par la contrainte et le cost-of-poor-quality.
- Un déploiement avec gates, et un rollback non négociable.
Déployer, ce n’est pas « pousser en production ». C’est « introduire un nouveau mode de défaillance en sécurité ». Traitez le rollout d’un modèle comme un changement de process. Cadencez. Limitez le blast radius. Faites un rollback vite.
- Une revue ops hebdomadaire où la dérive du modèle se traite comme une dérive de process.
Ne créez pas une cadence de revue IA à part. Intégrez-la au rythme opérationnel. Si la dérive augmente les minutes d’arrêt ou le rebut, on traite le sujet la même semaine, avec le même niveau de sérieux qu’une dérive mécanique.
- Une escalade claire quand la donnée casse.
La plupart des pannes d’IA sont en réalité des pannes de données. Quand la qualité à la source se dégrade, quelqu’un doit être responsable de corriger le capteur, le mapping PLC ou le tag SCADA. Pas le data scientist.
Pour les déploiements edge, je privilégie fortement des small models, conçus pour un objectif précis : ils simplifient le contrôle, la latence et les modes de défaillance. Si vous déployez sur des devices contraints ou dans des sites aux conditions dures, relisez pourquoi les small models sont souvent la seule manière raisonnable de déployer de l’IA à l’edge.
Un exemple vécu : pourquoi l’« IA centrale » ne passait pas à l’échelle, alors que les droits de décision, oui
Dans mes activités entrepreneuriales, notamment avec IBHQ et Shopeno, j’ai l’avantage de partir d’une page blanche. Vous pouvez concevoir des workflows où la métrique et le bouton d’arrêt sont explicites dès le premier jour. Si une décision automatisée touche au pricing, au risque ou à l’expérience client, vous définissez qui peut l’outrepasser et ce qui déclenche un fallback automatique. Ce n’est pas optionnel. C’est du product design.
Dans des environnements industriels plus grands, vous avez rarement ce luxe. La tentation est de créer une fonction IA centrale pour compenser une responsabilité morcelée. Sur le papier, c’est efficace. En pratique, cela devient une couche de traduction entre ceux qui subissent la douleur et ceux qui construisent le modèle. Les couches de traduction coûtent cher. Et elles ne tiennent pas à 2 h du matin quand une ligne est à l’arrêt.
Le levier qui marchait le mieux était toujours le même : pousser la responsabilité au plus près du terrain, et standardiser les contrôles. Un seul gate de mise en production. Une seule définition de métrique. Un seul mécanisme de rollback. Une seule file alignée sur les goulots. Des équipes centrales peuvent exister, mais comme facilitateurs, pas comme propriétaires.
C’est exactement l’état d’esprit que j’appliquais quand je portais la QA et les tests sur hardware et software. La qualité n’a pas progressé parce que la QA rédigeait de meilleurs rapports de bugs. Elle a progressé quand les critères de release sont devenus explicites et non négociables, et quand l’usine et l’ingénierie respectaient tous deux le bouton d’arrêt.
L’IA a besoin du même contrat. Pas de dashboards supplémentaires.
La checklist board pour ce trimestre
Si vous êtes membre de board, propriétaire ou dirigeant opérationnel, voici une grille de lecture utilisable dès demain. Elle tient sur une page et impose de la clarté.
- Nommez les 3 à 5 décisions que l’IA va modifier, et rattachez chacune à une métrique de contrainte (débit, rendement, arrêts, rebut, forecast-to-plan).
- Désignez un seul propriétaire opérationnel par décision. Si deux fonctions se la partagent, personne ne la porte.
- Définissez « suffisamment bon pour être mis en production » en termes business, plus les gates de risque technique. Écrivez-le.
- Exigez un chemin de rollback avant tout déploiement. Si le rollback est difficile, réduisez le périmètre du cas d’usage jusqu’à ce qu’il devienne sûr.
- Placez la responsabilité de la qualité de la donnée à la source. Faites de l’intégrité des capteurs et des tags un vrai job, avec escalade.
- Tenez une file unique de cas d’usage alignée sur les goulots et le cost-of-poor-quality. Stoppez les projets qui ne déplacent pas la contrainte.
- Intégrez la dérive au rythme ops hebdomadaire. Traitez-la comme toute dérive de process, avec actions correctives.
Si vous faites ces sept choses, vous cesserez de payer pour du théâtre IA. Et vous verrez que l’organigramme compte beaucoup moins. Parce que le système dira à chacun quoi faire.
Ma conclusion est volontairement directe : l’IA n’a pas besoin d’un nouveau département. Elle a besoin de droits de décision, de discipline sur les métriques et d’un bouton d’arrêt que les opérations ont le pouvoir d’actionner. Quand vous construisez cela, les outils commencent enfin à compter.
Cette logique de fiabilité dépasse l’IA. Si vous déployez des produits connectés sur le terrain, vous vous intéresserez peut-être aussi à la ruggedization comme contrat de fiabilité et à l’eSIM comme trust anchor dans le P&L IoT.
Newsletter
Des notes de terrain, directement dans votre boîte.
Des notes occasionnelles et sans bruit, prises de l'intérieur du travail : ce qui a été livré, ce qui a cassé, et ce que je ferais différemment.