26 October 2026 · 9 min de lecture
Le ransomware agentique n’est pas un nouveau risque. C’est un risque plus rapide.
Quand les attaquants automatisent toute la chaîne, la seule défense durable, ce sont des primitives de contrôle au niveau de l’automatisation : contraindre les outils, limiter le blast radius et s’entraîner à arrêter.
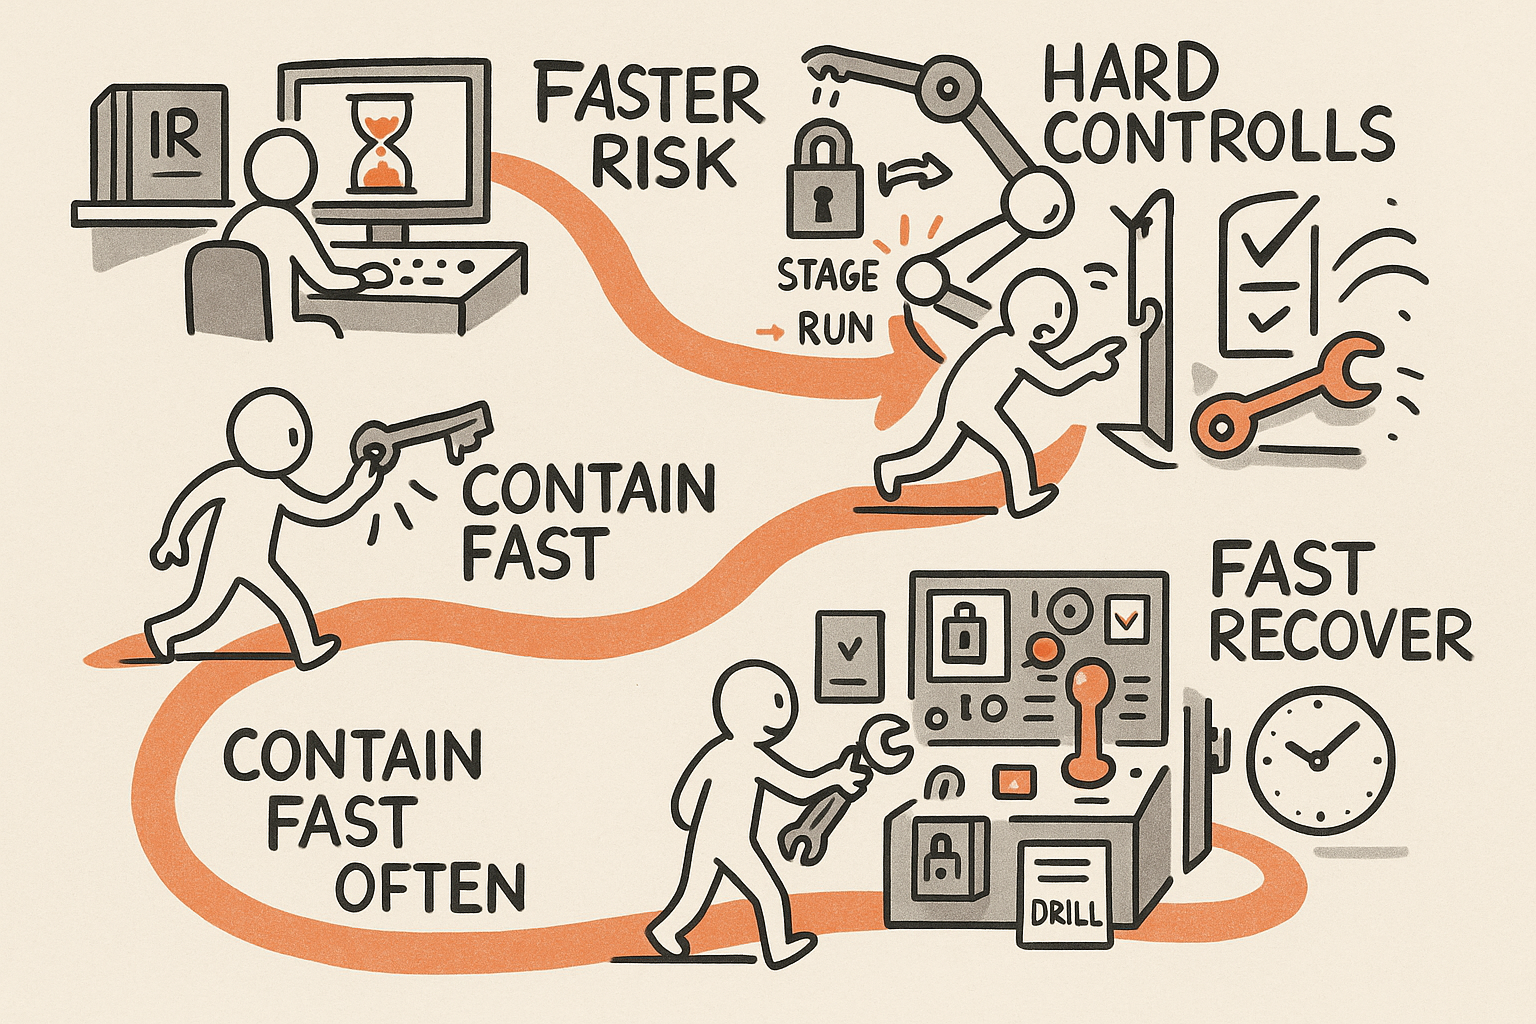
Je ne trouve pas les « attaques pilotées par l’IA » (intelligence artificielle) inquiétantes parce qu’elles seraient intelligentes. Je les trouve inquiétantes parce qu’elles sont rapides.
La vitesse change tout. Dans un incident mené par des humains, les défenseurs gagnent des minutes, parfois des heures, grâce aux frictions. Dans un incident automatisé, l’attaquant peut scanner, rebondir en privilèges, préparer les charges utiles et exécuter, dans une seule séquence continue. Votre organisation ne cède pas faute d’une règle de détection assez maligne. Elle cède parce que vos contrôles ont été conçus pour un monde où les gens devaient s’arrêter.
Dans les environnements industriels, nous avons appris cette leçon depuis longtemps. Nous n’avons jamais fait confiance à des comportements « smart » sans primitives de gouvernance que l’on peut montrer du doigt, tester et auditer. Les contraintes créent la fiabilité. La capacité à restaurer crée la confiance. L’espoir n’est pas un contrôle.
Ce texte reflète mon regard d’opérateur sur le ransomware agentique : considérez-le comme une automatisation plus rapide, puis répondez avec des contrôles au niveau de l’automatisation.
La compression du temps est le modèle de menace
Beaucoup de programmes cyber partent encore d’une chronologie avec des « coutures » humaines : un attaquant doit rechercher, fabriquer, itérer. Cette hypothèse se retrouve dans la gouvernance. Les validations prennent du temps. Les privilèges s’accumulent. Les logs sont modifiables. Les sauvegardes sont « quelque part ». La réponse à incident, c’est un PDF.
Quand la chaîne d’attaque est automatisée de bout en bout, ces coutures disparaissent. La boucle de l’attaquant devient : découvrir, exploiter, se propager, chiffrer, extorquer, le tout comme un seul processus machine. Vous n’avez pas le luxe de « vous en rendre compte » à mi-parcours si votre environnement autorise les mouvements latéraux et l’escalade de privilèges à la vitesse d’une machine.
Le premier changement de posture pour les boards et les équipes d’exploitation est simple : mesurez votre exposition en minutes, pas en jours. Si vos hypothèses de confinement et de reprise exigent des heures, vous vous préparez à une autre catégorie d’adversaire.
L’automatisation industrielle a eu raison sur un point : les contraintes battent la « créativité »
Quand j’ai passé des années en électronique de puissance et en automatisation industrielle, nous livrions des systèmes qui devaient continuer à tourner dans des stations d’eau et d’eaux usées, des infrastructures HVAC et des environnements de production. Dans ces univers, nous ne débattions pas pour savoir si un contrôleur était « smart ». Nous nous demandions s’il était borné.
Un système borné se comporte de façon prévisible sous stress. Il échoue selon des modes connus. Il expose un état clair. Il a des limites d’isolement. Il donne à l’opérateur un moyen d’arrêter et un chemin de redémarrage.
Plus tard, quand je dirigeais une business unit internationale dans le smart-building et les contrôles connectés, la même logique s’appliquait. Objets embarqués, passerelles, services cloud, installateurs et exploitants formaient un système socio-technique désordonné. La fiabilité ne venait jamais d’ajouter encore plus d’automatisation. Elle venait de mettre des barrières autour de l’automatisation.
Les attaquants « agentiques » exploitent l’inverse : l’automatisation non bornée de votre propre environnement. Des identités sur-privilégiées. Des réseaux plats. Des scripts qui peuvent tourner partout. Des logs modifiables depuis le même plan d’administration censé les auditer.
Si vous cherchez un principe qui tient dans le temps : rendez votre entreprise sûre pour l’automatisation. Autrement dit, concevez des contraintes pour que tout acteur rapide, malveillant ou simplement défaillant, se heurte vite à des limites non négociables.
Les primitives de contrôle qui comptent (et comment les mettre sous pression)
J’aime ramener la « sécurité agentique » à trois questions auxquelles un opérateur peut répondre sans slides :
- Quels outils peuvent s’exécuter ?
- Où peuvent-ils s’exécuter ?
- Comment arrête-t-on et comment redémarre-t-on ?
1) Définir la toolchain : le moindre privilège pour l’automatisation, pas pour les personnes
La plupart des organisations traitent le moindre privilège comme un sujet RH : arrivées, mobilités, départs. C’est nécessaire, mais cela rate le problème actuel : les identités d’automatisation.
Vos identifiants les plus risqués sont souvent non humains : runners CI/CD, bots RPA, clés d’intégration, tokens de provisioning d’appareils, comptes de service, et accès admin « temporaires » donnés à des scripts.
- Inventoriez les identités d’automatisation et gérez-les comme des actifs de production.
- Cadrez leurs permissions sur une tâche unique. Si un build runner peut aussi accéder à des secrets de production, vous avez construit un pont d’attaque.
- Faites tourner et expirer les identifiants par défaut. Les tokens longue durée sont des incidents au ralenti.
- Exigez une exécution signée pour les scripts et binaires privilégiés. Si ce n’est pas vérifiable, ce n’est pas exécutable.
C’est aussi un domaine où l’IA appliquée peut aider côté défense : non pas en « détectant des hackers », mais en réconciliant en continu ce que des identités devraient faire et ce qu’elles font réellement. Mais cela ne fonctionne que si le modèle d’autorisations est propre.
2) Segmenter pour de vrai : ramener le blast radius à un niveau que vous pouvez absorber
En usine, la segmentation n’est pas une best practice. C’est le mécanisme qui évite qu’un défaut dans une cellule n’arrête toute l’usine. En cybersécurité, c’est identique. Si votre réseau est plat, votre incident est global par construction.
- Segmentez par fonction et criticité : postes utilisateurs, systèmes de build, applications métier, systèmes opérationnels, sauvegardes, logging, et infrastructure d’identité.
- Refusez par défaut les flux east-west. N’autorisez que les flux précis que vous pouvez justifier sur une page.
- Séparez vos « clés du royaume » : l’administration du fournisseur d’identité, des backups, du logging et de la production ne doit pas reposer sur le même plan.
- Concevez pour le confinement : partez du principe qu’un segment sera compromis. Votre job est d’éviter que cela devienne deux.
Si vous êtes dans l’IoT ou le smart-building, rappelez-vous que les choix de connectivité deviennent des choix de confiance. Dès que vous traitez la connectivité comme « juste des données », vous oubliez le plan de contrôle que vous exposez. J’ai développé cet état d’esprit dans eSIM as a trust anchor, car le modèle économique oublie souvent de budgéter le modèle de sécurité.
3) Rendre logs et backups résistants à l’adversaire : immuables, hors chemin, audités
Les attaquants automatisés ne se contentent pas de chiffrer des données. Ils s’attaquent à votre capacité à comprendre ce qui s’est passé et à votre capacité à restaurer. C’est pour cela que « nous avons des backups » n’est pas une phrase. C’est un système.
- Écrivez les logs dans un stockage immuable que les admins de production ne peuvent pas modifier.
- Placez les backups hors du plan d’identité principal. Si un compromis SSO permet aussi la suppression des sauvegardes, vous n’avez pas de sauvegardes.
- Testez les restaurations selon une cadence. Le temps de restore est un KPI, pas une hypothèse rassurante.
- Suivez votre recovery point objective comme une exposition financière. Quelle quantité de données pouvez-vous vous permettre de perdre ?
C’est la différence entre être attaqué et être en faillite opérationnelle.
Répétez le kill switch comme un arrêt d’urgence
Dans l’industrie, on s’entraîne aux arrêts d’urgence parce que, le jour où vous en avez besoin, c’est le pire moment pour découvrir une ambiguïté. Il devrait en aller de même pour des incidents cyber portés par l’automatisation.
Je ne parle pas d’une war room. Je parle d’un playbook de kill switch, praticable :
- Droits de décision sur une page : qui peut isoler des réseaux, désactiver le SSO, geler les déploiements et couper des intégrations.
- Actions d’isolement prédéfinies : mettre un segment en quarantaine, désactiver des tokens non humains, arrêter les build runners, révoquer des sessions privilégiées.
- Communications répétées : interne, clients, fournisseurs. Le silence crée le chaos.
- Reprise en clean room : un environnement sain, identifié, et une procédure pour reconstruire les services critiques sans faire confiance au plan compromis.
Quand je construis et j’opère mes propres ventures comme Shopeno et IBHQ, je traite « arrêter et restaurer » comme une exigence produit, pas comme une tâche IT. Les petites équipes ne survivent pas grâce à la chance. Elles survivent parce qu’elles savent restaurer. La même discipline se renforce avec l’échelle : plus l’organisation est grande, plus il faut répéter, parce que la coordination devient le goulot d’étranglement.
Si vous voulez une version plus développée de cette lecture d’opérateur, j’ai posé l’idée plus largement dans AI value and the stop button. Le contrôle fait la valeur.
Une lecture de board : des contrôles qui tiennent quand l’attaquant va plus vite que vous
Si vous siégez à un board ou dirigez une business unit, vous n’avez pas besoin de devenir architecte sécurité. En revanche, vous devez exiger les bonnes preuves.
Voici les questions que je poserais en revue trimestrielle, et je n’accepterais pas de réponses vagues :
- Blast radius : si un endpoint est compromis, quel est le dommage maximal avant confinement ?
- Identités d’automatisation : combien d’identifiants non humains existent, où sont-ils stockés et lesquels peuvent toucher la production ?
- Preuve de segmentation : montrez-moi les dix principaux flux east-west autorisés, et qui les a validés.
- Immuabilité : quels logs et backups sont réellement immuables, et qui peut les supprimer ?
- Drills de restore : quand a eu lieu le dernier test de restauration réussi d’un système critique, et combien de temps cela a pris de bout en bout ?
- Drill de kill switch : quand avons-nous répété pour la dernière fois la désactivation du SSO ou l’isolement d’un segment, et qu’est-ce qui a cassé ?
C’est de la gouvernance opérationnelle. Le même muscle que celui qui sert à piloter la qualité, la sécurité et l’uptime. D’ailleurs, si le parallèle avec l’industrie vous parle, vous reconnaîtrez le motif dans ruggedization as a reliability contract. La sécurité est aussi un contrat. Vous le payez, et vous l’imposez.
Mon avis : l’autonomie est un privilège qui se mérite
Le ransomware agentique agit comme un révélateur. Il n’impose pas une nouvelle philosophie. Il impose du sérieux opérationnel.
L’autonomie, qu’il s’agisse de vos propres agents IA ou de l’automatisation d’un attaquant, n’est sûre que si elle est bornée par des contrôles durs : toolchains au moindre privilège, segmentation réelle, preuves immuables, et arrêts répétés. Les organisations qui gagneront ne seront pas celles avec les dashboards les plus séduisants. Ce seront celles capables de confiner vite, décider vite et restaurer vite.
C’est la même leçon que j’ai retenue des systèmes proches de l’usine, des devices embarqués et des opérations multi-pays : les contraintes créent la fiabilité, et la capacité à restaurer crée la vitesse. Le reste, c’est du théâtre.
Newsletter
Des notes de terrain, directement dans votre boîte.
Des notes occasionnelles et sans bruit, prises de l'intérieur du travail : ce qui a été livré, ce qui a cassé, et ce que je ferais différemment.