26 October 2026 · 8 min de lecture
Les LLM ont leur place dans la couche narrative, pas dans la couche de vérité financière
Utilisez les modèles de langage pour expliquer les chiffres, pas pour les produire.
J’aime la vitesse. J’aime réduire les étapes manuelles. J’aime tout outil qui élimine le travail inutile d’un cycle de clôture.
En revanche, je n’aime pas l’ambiguïté quand il s’agit de vérité financière.
Les grands modèles de langage sont, par nature, probabilistes. Le reporting financier doit être déterministe, traçable et reproductible. Ces deux mondes peuvent coexister, mais à condition d’installer une frontière architecturale nette entre les deux.
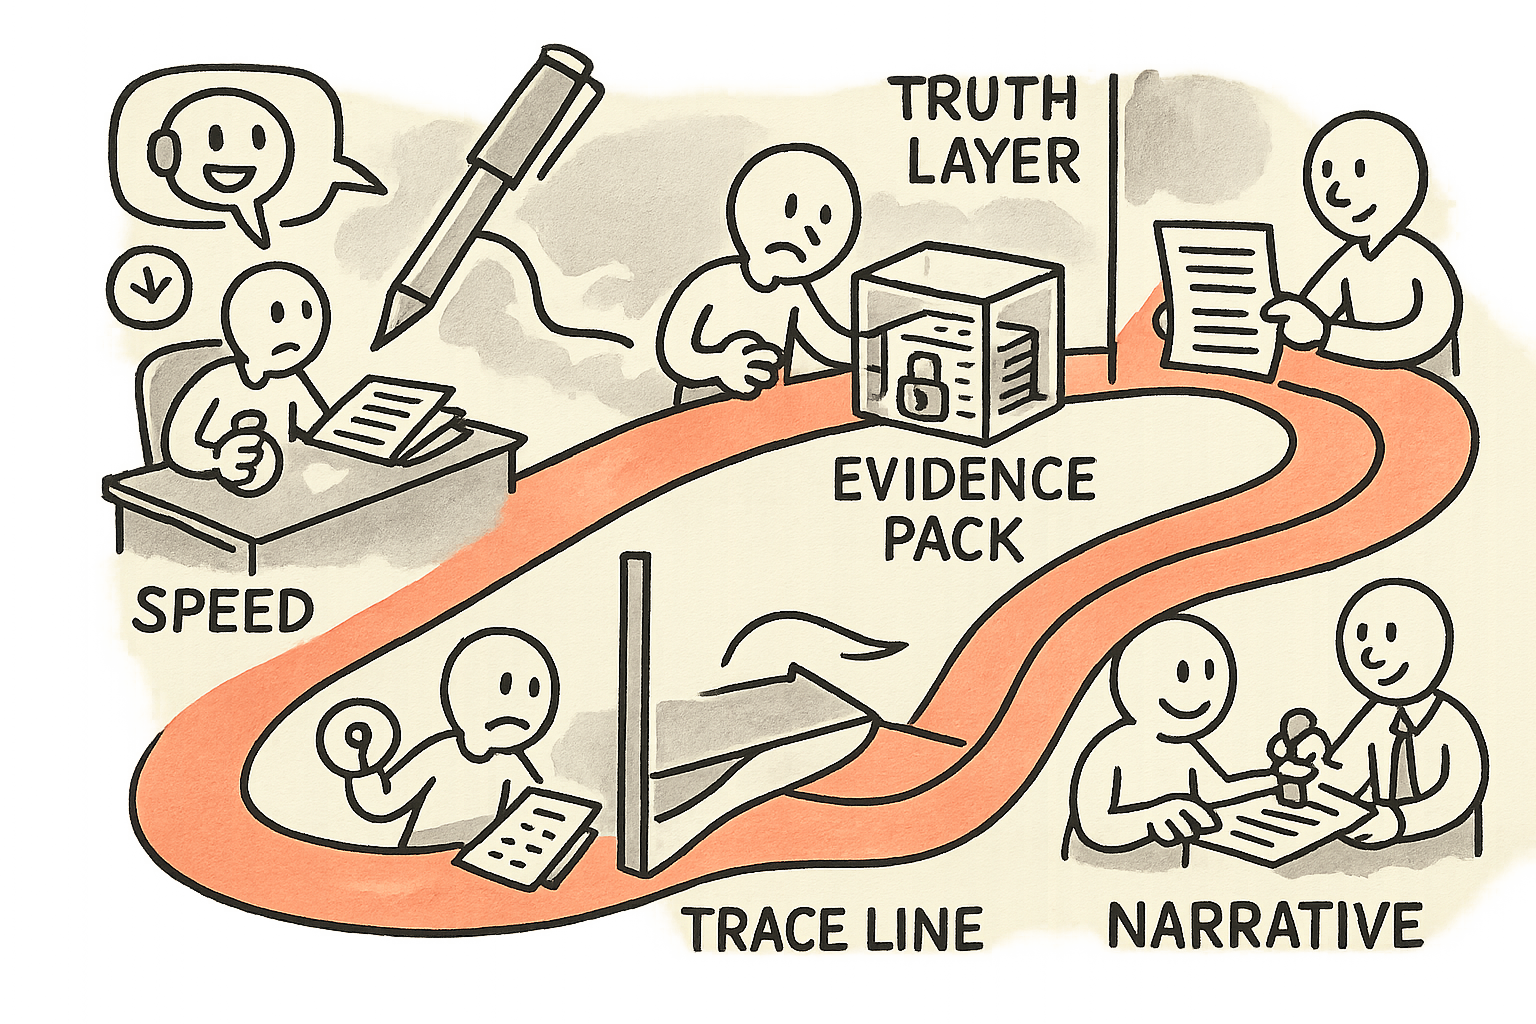
Ma position est simple : les LLM ont leur place dans la couche narrative, pas dans la couche de vérité financière. Ils peuvent rédiger des commentaires d’écarts, assembler des textes de disclosure, et vous aider à expliquer ce qui s’est déjà produit. Ils ne doivent jamais générer, transformer, « corriger » ou rapprocher des chiffres. Ils ne doivent jamais être l’endroit où vivent les contrôles. Et ils ne doivent jamais être le système qui modifie, en silence, ce qui est considéré comme vrai.
J’ai adopté cette discipline bien avant l’IA générative. Quand j’étais responsable QA et test, à cheval entre hardware et software, puis à la tête d’organisations de R&D, je suivais une règle : si vous ne pouvez pas le tracer, vous ne pouvez pas le livrer. Pour le reporting, c’est la même exigence, avec des conséquences plus lourdes. Si vous ne pouvez pas le tracer, vous ne pouvez pas le reporter.
Le modèle à deux couches : vérité versus narration
La plupart des équipes mélangent ces couches sans s’en rendre compte. Un tableur est dupliqué. Un chiffre est reclassé « juste pour le deck ». Quelqu’un retouche une explication après coup. Et, peu à peu, l’histoire finit par guider les chiffres.
Avec des LLM, le risque augmente fortement, parce que l’outil est conçu pour produire une réponse plausible. Il n’est pas conçu pour préserver une chaîne de traçabilité.
Je sépare donc le système en deux couches explicites :
- Couche de vérité financière : grands livres, sous-livres, data warehouse, calculs déterministes, règles comptables versionnées, validations et sign-offs. Tout y est reproductible et auditable.
- Couche narrative : commentaires de management, rédaction de disclosure, explication des écarts, et Q&A pour les parties prenantes internes. Tout y est dérivé, jamais faisant autorité.
Cette frontière est structurante, car elle fixe la posture de gouvernance. Dans la couche de vérité, vous partez du principe que chaque changement doit être explicable et attribuable. Dans la couche narrative, vous exigez que chaque phrase soit étayée, tout en acceptant que l’écriture soit itérative.
Si vous voulez une analogie issue de la tech industrielle : considérez le ledger comme un capteur, et le LLM comme une annotation sur un dashboard. Vous pouvez modifier l’annotation toute la journée. Vous n’« améliorez » pas la mesure du capteur avec de l’écriture créative.
Un design auditable : data-to-text, pas text-to-data
En contexte réglementé, la seule approche à laquelle je fais confiance est une chaîne data-to-text. Pas du text-to-data. Et certainement pas « discuter avec les chiffres et laisser l’outil mettre à jour le tableur ».
Voici l’architecture que je présenterais à un comité d’audit.
- Source de vérité verrouillée : grand livre et tables de warehouse gouvernées. Immutables là où c’est nécessaire, et avec des accès contrôlés partout.
- Couche de calcul déterministe : agrégations, mappings, éliminations, logique FX, règles d’allocation. Règles versionnées et exécutions reproductibles. Zéro étape cachée.
- Evidence pack immuable : les requêtes exactes exécutées, les valeurs de paramètres, des snapshots des jeux de résultats, des liens vers les tables sources, des horodatages, et l’identité de l’exécution. Voyez cela comme un « build artifact » du reporting.
- LLM contraint au pack : le modèle ne voit que l’evidence pack et un template de reporting fixe. Il rédige le commentaire et le texte de disclosure, et il doit citer quel artefact supporte quelle affirmation.
- Journaux de changements et validations : les modifications du narratif sont tracées. Le sign-off final reste humain et référence l’ID de l’evidence pack utilisé.
C’est le même principe opérationnel que j’appliquais à la tête d’équipes R&D internationales. Nous n’acceptions pas « ça marche sur ma machine ». Nous exigions des build artifacts, des dépendances versionnées et des preuves de test. Le reporting mérite le même niveau de preuve.
Si vous voulez approfondir les garde-fous opérationnels autour de l’IA, vous retrouverez la même logique dans mon article sur pourquoi le bouton stop est la vraie valeur de l’IA. Le reporting a lui aussi besoin d’un bouton stop. Il s’appelle : « pas de preuve, pas de phrase ».
Ce dans quoi les LLM excellent (et ce qu’ils ne doivent pas faire)
Utilisés correctement, les LLM peuvent supprimer les tâches à plus faible valeur du reporting finance et ESG. Celles qui consomment du temps senior et créent des erreurs par fatigue.
Voici de bons usages :
- Rédiger des commentaires d’écarts à partir d’un arbre d’écarts prédéfini (prix, volume, mix, one-offs), en s’appuyant uniquement sur l’evidence pack.
- Assembler des textes de disclosure en combinant des blocs validés avec des faits spécifiques à la période, là encore référencés à des preuves.
- Retrouver les éléments de preuve pour répondre à des questions internes, tant que la recherche se fait dans des référentiels gouvernés, et non sur le web ouvert.
- Vérifier la cohérence du langage : les explications se contredisent-elles, les définitions dérivent-elles d’une section à l’autre, emploie-t-on le même terme pour le même concept.
Voici de mauvais usages, même s’ils semblent efficaces en démo :
- Générer des chiffres (« estimer des données manquantes », « combler des trous », « lisser des anomalies »). C’est de la modélisation, pas du reporting.
- Transformer des chiffres dans un prompt (« convertir ce tableau en chiffre d’affaires reporté par région »). Ce type de transformation doit passer par une couche déterministe, avec une logique versionnée.
- Corriger des données (« ça a l’air faux, ajuste-le »). L’outil ne peut pas porter le contrôle. Les équipes doivent investiguer en amont, puis relancer la chaîne déterministe.
- Auto-approuver des brouillons ou des sign-offs. Une signature doit refléter une responsabilité, pas un confort.
Dans mes propres entreprises, notamment IBHQ et Shopeno, je pense l’IA de la même manière : qu’elle accélère les décisions, sans remplacer le system of record. Dès que le modèle devient le record, vous perdez à la fois la confiance et la capacité à diagnostiquer.
Des contrôles que vous pouvez mettre en place ce trimestre
Si vous êtes CFO, responsable du contrôle de gestion, responsable reporting, ou membre de board qui demande « que fait-on maintenant ? », je commencerais par une checklist courte. Ce sont des gestes d’opérateur, pas de la théorie.
1) Écrire la politique de séparation en une page
- Une sortie de LLM n’est jamais un enregistrement financier.
- Un LLM ne peut que rédiger du texte et doit référencer des artefacts de preuve.
- Aucun outil LLM n’a de droits d’écriture sur le ledger, le warehouse ou le moteur de consolidation.
Cette politique évite les raccourcis « utiles » qui, plus tard, se transforment en dette de process invisible.
2) Construire un evidence pack comme un artefact de release software
- Stockez les requêtes et paramètres ayant produit chaque tableau reporté.
- Stockez des snapshots des résultats, pas uniquement des liens.
- Attribuez un ID unique au pack et faites-en l’ancre de chaque brouillon narratif.
Ayant dirigé la qualité en électronique de puissance, j’ai vu à quelle vitesse les équipes se disciplinent dès lors que chaque incident se rattache à un build précis. La qualité du reporting s’améliore de la même façon quand chaque affirmation se rattache à un artefact précis.
3) Imposer des citations dans le narratif
N’acceptez pas de commentaires en texte libre sans références. Exigez que le brouillon inclue des citations internes, par exemple : « EvidencePack:2026-05 CloseRun:14 Query:RevenueByRegion_v3 ». Si le modèle ne peut pas citer, il doit répondre : « preuves insuffisantes ».
4) Encadrer le commentaire d’écarts avec un template gouverné
- Définissez l’arbre d’écarts une fois.
- Définissez ce qui relève d’un one-off.
- Définissez des seuils : quand le modèle peut proposer un narratif, et quand il doit escalader vers un owner.
Vous réduisez ainsi le risque de dérive narrative, et vous rendez les commentaires comparables d’un trimestre à l’autre.
5) Séparer « rédaction » et « approbation » dans les outils
Le LLM peut vivre dans un environnement de rédaction. L’approbation doit se faire dans un workflow contrôlé, avec identité, horodatages, et sign-off explicite. C’est la même séparation que les équipes industrielles appliquent entre un banc de test et une ligne de production.
La question au niveau board : qu’optimise-t-on exactement ?
La plupart des débats sur l’IA dans le reporting se bloquent sur les économies de main-d’œuvre. Ce n’est pas la bonne fonction objectif.
Le vrai objectif, c’est : réduire le cycle sans augmenter le risque d’audit.
Quand je dirigeais une business unit multi-pays avec responsabilité complète sur le P&L, la clôture n’était pas qu’une activité finance. C’était un rythme de pilotage. Les échanges sur le forecast, les décisions d’inventaire et les arbitrages commerciaux dépendent de la confiance dans les chiffres. Dès que la confiance baisse, tout ralentit. On recontrôle. Les réunions deviennent des débats sur la donnée, au lieu de décisions.
Je ne veux donc pas du « reporting par IA ». Je veux une accélération auditable. Rédaction plus rapide, revue plus rapide, contrôles de cohérence plus rapides. Même couche de vérité. Même ownership des contrôles.
C’est aussi la raison pour laquelle je reste attentif à la taille des modèles et aux schémas de déploiement en environnement opérationnel. Livrer une IA fiable, c’est une question de contraintes, pas d’ambition. On retrouve ce thème dans mon article sur pourquoi les petits modèles sont souvent la seule manière raisonnable de livrer à l’edge. En reporting, l’équivalent est un modèle contraint dans un contexte contraint.
Ma conclusion : garder la machine honnête en la tenant à l’écart de la vérité
Les LLM peuvent réellement améliorer le reporting. Ils peuvent réduire la rédaction répétitive, clarifier les messages et raccourcir les cycles. Ils peuvent même relever le niveau en imposant un langage et une structure cohérents.
Mais uniquement si vous êtes strict sur leur périmètre.
Mettez-les dans la couche narrative. Donnez-leur un evidence pack immuable. Exigez des citations. Tracez chaque changement. Gardez des calculs déterministes et versionnés. Gardez des validations humaines et responsables.
C’est ainsi que vous captez les bénéfices sans sacrifier la seule chose dont le reporting ne peut pas se passer : la vérité financière.
Newsletter
Des notes de terrain, directement dans votre boîte.
Des notes occasionnelles et sans bruit, prises de l'intérieur du travail : ce qui a été livré, ce qui a cassé, et ce que je ferais différemment.