26 October 2026 · 9 min de lecture
Le runbook de reprise après incident IA que les dirigeants oublient systématiquement
Concevez une dégradation maîtrisée pour vos fonctionnalités IA : RTO/RPO explicites, modes de repli et kill switch qui préserve le workflow.
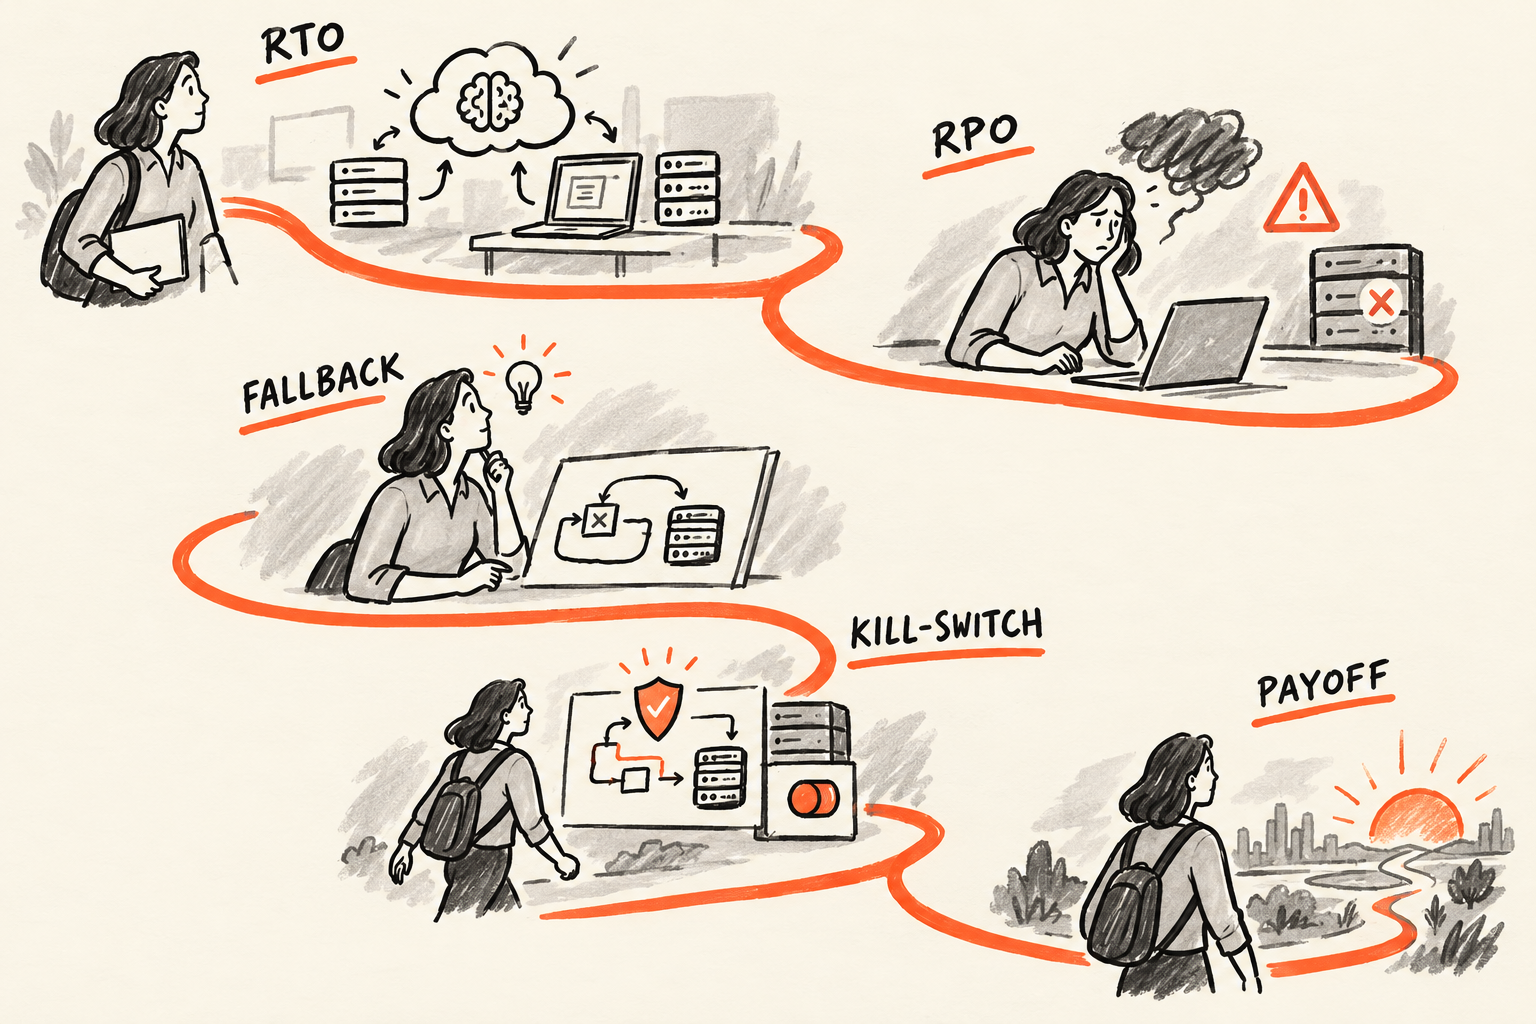
La plupart des fonctionnalités IA sont livrées comme si elles échappaient aux règles du logiciel en production.
On parle prompts, evals et choix de modèle. Puis il se passe quelque chose de parfaitement prévisible : le vendor vous rate-limit, la couche de policy se met à bloquer une catégorie dont vous dépendez, le comportement du modèle change ou votre équipe juridique revoit ce que « autorisé » veut dire. D’un coup, la voie IA disparaît et le produit n’a plus qu’une posture : « Désolé, réessayez plus tard. »
La vérité dérangeante est simple. Si l’IA se trouve au milieu d’un processus de revenus, de support, d’un processus réglementé, ou de toute situation où des humains attendent, vous lui devez le même niveau de réflexion sur la continuité que celui que vous appliquez déjà aux paiements, à l’identité ou à votre base de données. Pas les mêmes méthodes, mais la même exigence.
Voici le runbook qui manque : comment définir RTO et RPO pour des capacités IA, comment concevoir une dégradation maîtrisée, et quand désactiver un agent de manière franche sans « briquer » le workflow. Ce texte est inspiré par « Building resilient AI-powered software, and planning for when things go wrong », qui a raison de faire entrer la logique de disaster recovery dans la discussion IA.
Commencez par nommer la vraie dépendance : la « supply chain » de l’IA
Quand une fonctionnalité IA tombe, la panne se situe rarement en un seul point. Elle peut venir de n’importe quel maillon :
- Exécution du modèle : pics de latence, timeouts, limites de capacité, panne régionale.
- Périmètre contractuel du vendor : rate limits, quotas épuisés, changements de pricing, dépréciations.
- Couche de policy : modération, filtres de safety, garde-fous de gouvernance internes, contraintes de résidence des données.
- Couche de contexte : index RAG obsolète, dérive des embeddings, permissions erronées, documents manquants.
- Couche outillage : un agent peut appeler le CRM, le ticketing, l’email, un repo de code. Qu’un seul de ces services soit indisponible, et le « smart » devient « bloqué ».
Si vous traitez « l’IA » comme une seule dépendance, vous écrirez un runbook propre sur le papier, inefficace dans la réalité. Le runbook doit relier les modes de défaillance à ce que l’utilisateur voit et subit. Tout l’enjeu est là.
Rendez RTO et RPO explicites pour l’IA, même si vous détestez ces termes
En DR classique, le RTO correspond au temps d’indisponibilité acceptable. Le RPO, à la quantité de perte de données tolérable. Pour l’IA, les équivalents existent, mais beaucoup d’équipes évitent de les formuler parce que cela met à nu des ambiguïtés produit.
Voici une traduction opérationnelle :
- IA-RTO : combien de temps le parcours assisté par l’IA peut être indisponible avant que vous deviez basculer les utilisateurs vers une voie alternative qui permet quand même de finir le travail.
- IA-RPO : quelle part du travail produit par l’IA vous pouvez vous permettre de perdre ou d’invalider. Pensez brouillons, classifications, résumés, champs pré-remplis, réponses suggérées, changements de code proposés.
Deux règles rendent l’exercice praticable.
- Le RTO appartient au processus métier, pas à l’équipe d’ingénierie. Si l’IA aide à closer des deals, qui peut accepter quatre heures de coupure ? Si elle aide à trier des incidents, qui peut accepter cinq minutes ?
- Le RPO relève surtout de la confiance, pas du stockage. Si la sortie du modèle disparaît, l’utilisateur peut-il la reconstituer ? Si elle devient ensuite non conforme, pouvez-vous la retirer ?
Écrivez ces paramètres par capacité IA, pas par produit. Votre « assistant de réponse email » et votre « agent de décision de remboursement » ne doivent pas partager la même cible de continuité.
Concevez des chemins de dégradation, pas des « pages d’indisponibilité »
La dégradation maîtrisée n’est pas une bannière « L’IA est temporairement indisponible ». C’est un itinéraire alternatif déjà construit, qui termine malgré tout le workflow.
J’utilise trois modes de repli. Choisissez-en un par capacité et câblez le basculement à l’avance.
Mode 1 : assister uniquement, ne jamais bloquer
C’est la posture la plus simple. L’IA propose, mais l’utilisateur peut toujours terminer manuellement. Si l’IA tombe, le produit fonctionne encore, simplement plus lentement.
- Exemple : tags de tickets suggérés, release notes en brouillon, résumé d’appel.
- Exigence de design : l’UI ne doit pas dépendre de la suggestion pour débloquer l’étape suivante.
- Action runbook : en cas d’échec, masquer les éléments IA, préserver la saisie utilisateur, journaliser l’incident.
Mode 2 : résultats en cache ou rejouables
Certaines tâches sont trop coûteuses ou trop lentes à régénérer, et les utilisateurs n’accepteront pas de perdre le résultat. Ici, vous traitez la sortie de l’IA comme un artefact calculé : vous devez l’enregistrer et pouvoir le rejouer.
- Exemple : transformation d’un long document, rapport d’analyse attaché à un dossier, ensemble de champs extraits qui alimente le travail en aval.
- Exigence de design : stocker la sortie avec sa provenance (modèle, version du template de prompt, sources de retrieval). C’est votre « poignée de rejeu ».
- Action runbook : si le vendor est down, servir le dernier artefact valide avec un indicateur de fraîcheur, et mettre la régénération en file.
Mode 3 : repli déterministe
Pour certaines capacités, vous pouvez remplacer « l’intelligence » par une logique déterministe plus simple, moins bonne, mais sûre.
- Exemple : règles de routage, classification par mots-clés, templates, arbres de décision statiques.
- Exigence de design : définir le comportement minimal acceptable qui préserve la conformité et les promesses client.
- Action runbook : basculer en mode déterministe quand la confiance baisse, pas uniquement quand le modèle est injoignable.
La question clé au niveau exécutif n’est pas « avons-nous un fallback ? ». C’est : quelle expérience dégradée sommes-nous prêts à livrer volontairement.
Le point difficile : quand le modèle répond, mais se trompe
Le DR traditionnel est confortable parce qu’une panne est binaire. Avec l’IA, l’échec ressemble souvent à : « le service tourne, mais les réponses sont subtilement cassées ». C’est ce type d’incident qui abîme la marque et ouvre un risque réglementaire.
Il vous faut des déclencheurs qui ne dépendent pas de l’uptime :
- Déclencheur de régression qualité : les scores d’evals baissent, les rejets en revue humaine augmentent, ou des métriques aval dévient fortement.
- Déclencheur de régression policy : la modération commence à bloquer un travail légitime, ou cesse de bloquer des contenus que vous ne pouvez pas livrer.
- Déclencheur d’anomalie de coût : la consommation de tokens par tâche grimpe, souvent parce que prompts ou appels outils gonflent.
Quand ces déclencheurs se produisent, votre runbook ne doit pas dire « investiguer ». Il doit dire « basculer de mode ». Un incident de qualité exige la même netteté qu’un incident de sécurité : contenir d’abord, analyser ensuite.
Un kill switch qui ne met pas l’activité à l’arrêt
Aujourd’hui, toutes les équipes affirment avoir un kill switch IA. Pour beaucoup, cela se résume à révoquer une clé API. Ce n’est pas un kill switch. C’est une panne que vous provoquez.
Un vrai kill switch a trois propriétés :
- Scopé : vous pouvez désactiver une capacité, un tenant, une géographie, un canal ou une intégration outil, sans éteindre tout le produit.
- Réversible : vous pouvez réactiver en sécurité, avec une montée progressive (rollout en pourcentage, gating par cohortes).
- Qui préserve le workflow : le parcours utilisateur se termine malgré tout, via l’un des modes de dégradation ci-dessus.
C’est l’endroit où feature flags, configuration de policy et design UI se rencontrent. C’est aussi là que beaucoup de projets « agentic » s’effondrent : on branche un agent sur un chemin critique, puis on découvre qu’il n’existe aucun état intermédiaire sûr entre « l’agent tourne » et « le workflow est mort ».
La manière la plus simple d’éviter cela est d’exiger une phrase en design review : « Si nous désactivons cet agent à 10:00, comment un utilisateur termine-t-il la tâche à 10:01 ? » Si la réponse reste floue, vous n’avez pas un produit. Vous avez une démo.
Le template de runbook par lequel j’aimerais voir plus d’équipes commencer
Vous n’avez pas besoin d’un classeur de cent pages. Il vous faut une page par capacité IA, écrite en langage simple, exécutable par une personne on-call sous pression.
- Capacité : ce que fait l’IA (un verbe). Rédige des réponses. Extrait des champs. Suggère des actions. Exécute des actions.
- Propriétaire métier : qui décide ce que signifie une « dégradation acceptable ».
- IA-RTO et IA-RPO : délai de bascule vers le repli, et perte de sortie tolérable.
- Dépendances : vendor du modèle, vector store, modération, intégrations outils.
- Modes de défaillance : vendor down, latence, quota, blocage policy, dérive qualité, panne d’un outil.
- Mode de repli : assistance uniquement, cache, déterministe.
- Périmètre du kill switch : par tenant, par fonctionnalité, par outil, par géographie.
- Message utilisateur : ce que dit le produit en mode dégradé. Pas d’excuses : des instructions et un statut.
- Gestion des données : ce qui est stocké, combien de temps, et comment retirer des sorties si nécessaire.
- Observabilité : les trois signaux à surveiller (qualité, policy, coût) plus la latence et le taux d’erreur.
Une capacité, une page. Si vous n’arrivez pas à tenir sur une page, le design n’est pas prêt.
Une leçon vécue : la continuité bat l’astuce
J’ai vu une organisation R&D livrer des fonctionnalités « smart » spectaculaires en sprint review, puis générer discrètement de la charge support parce que le produit n’avait aucun mode dégradé. Le plus surprenant n’était pas le modèle qui se comportait mal. C’était la vitesse à laquelle l’équipe a normalisé des prouesses manuelles pour éviter de bloquer les clients.
C’est cela qu’un runbook DR IA évite. Pas les incidents. Les incidents arriveront. Il évite l’acceptation progressive du chaos comme mode de fonctionnement normal.
Le lien avec le coût et l’ownership
La résilience ne se limite pas à l’uptime. Elle concerne aussi la prévisibilité des dépenses et la clarté des responsabilités quand les choses dérapent. Si vous voulez aborder le sujet côté finance, cela s’articule naturellement avec The CFO-Grade Playbook to Prevent Agentic COGS Shock. Si vous voulez l’angle gouvernance, lisez AI Sprawl in Danish SMEs Is Not an AI Problem. It’s a Money-and-Risk Ownership Problem.
Mon point de vue : traitez l’IA comme une dépendance à plusieurs niveaux, pas comme une couche magique
L’IA (intelligence artificielle) n’est pas particulière parce qu’elle est intelligente. Elle l’est parce qu’elle échoue de plus de façons que ce à quoi la plupart des équipes sont habituées, et parce que beaucoup de ces échecs ressemblent à un succès jusqu’au moment où un client se plaint.
Si vous ne faites qu’une chose ce trimestre, faites celle-ci. Prenez vos trois principales capacités IA et écrivez leurs runbooks d’une page. Donnez à chacune un IA-RTO et un IA-RPO explicites. Choisissez un mode de dégradation qui permet toujours de terminer le travail. Mettez en place un kill switch scopé, qui ne « brique » pas le workflow.
C’est ce qui rend l’IA suffisamment sûre pour être placée au milieu du business, pas uniquement à la périphérie.
Si vous voulez un second regard sur votre posture DR IA, contactez-moi via la page de contact et dites-moi quels workflows vous ne pouvez pas vous permettre de casser.
Newsletter
Des notes de terrain, directement dans votre boîte.
Des notes occasionnelles et sans bruit, prises de l'intérieur du travail : ce qui a été livré, ce qui a cassé, et ce que je ferais différemment.