26 October 2026 · 8 min de lecture
La modération par l’IA a besoin d’un budget d’erreur et d’un kill switch
Les bonnes intentions ne protègent pas les utilisateurs. Les systèmes de contrôle, si.
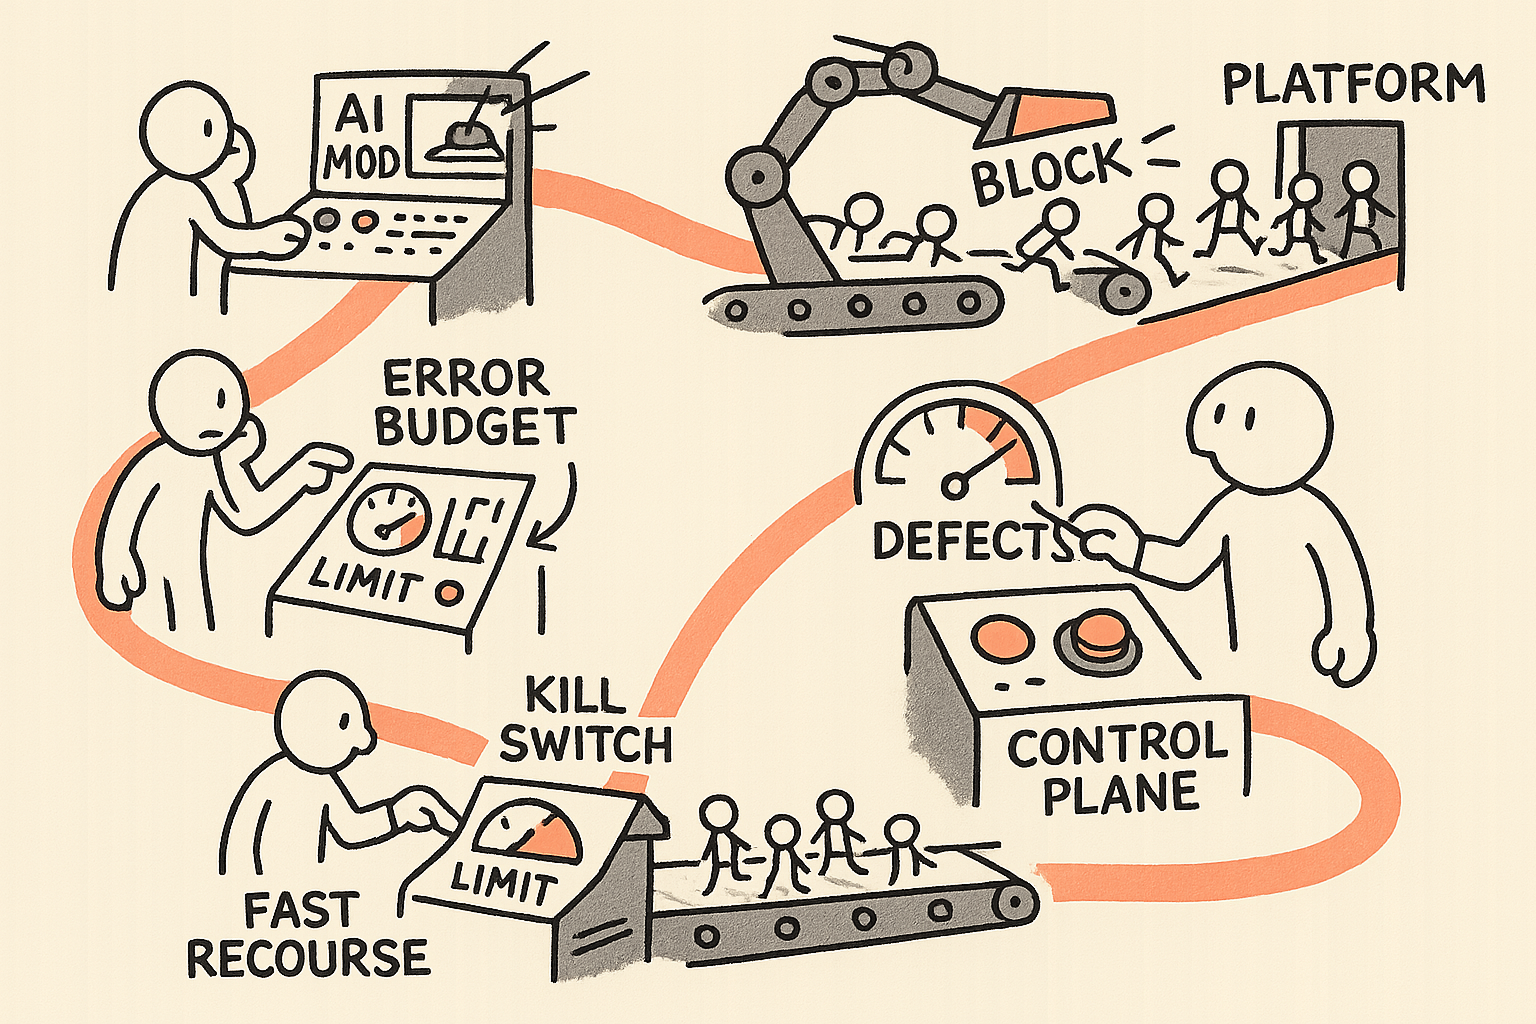
On parle souvent de la modération par l’IA comme d’éthique. En opérations, c’est du contrôle.
Si votre système peut retirer du contenu, réduire la portée ou suspendre un compte, ce n’est pas « juste » un modèle. C’est un actionneur. Et avant de toucher des utilisateurs réels, tout actionneur a besoin de trois choses : un budget d’erreur, un kill switch et un workflow de recours qui rétablit le service rapidement.
J’ai appris cela bien avant l’IA (intelligence artificielle). Pendant mes années en QA et en pilotage des tests en électronique grand public, et avant cela dans l’électronique de puissance appliquée à l’automatisation et au HVAC, nous traitions l’automatisation comme une ligne de production. Un faux positif était un défaut. Un défaut non détecté était aussi un défaut. Dans les deux cas, il y avait un coût mesurable, une cause racine et une condition d’arrêt. Les systèmes Trust and Safety méritent la même rigueur, parce que le résultat n’est pas un indicateur sur un dashboard. C’est la capacité d’un utilisateur à participer à une plateforme.
La modération est une ligne de production critique pour le chiffre d’affaires
Les opérateurs sous-estiment l’impact commercial des faux positifs en modération parce que cela paraît « intangible ». Ça ne l’est pas.
- Les faux positifs créent du churn. Vous bloquez des utilisateurs légitimes, et ils ne reviennent pas. Et même s’ils reviennent, la confiance est entamée.
- Les faux positifs saturent le support. Chaque action injustifiée devient un ticket, une revue manuelle et un backlog que vous ne résorbez jamais complètement.
- Les faux positifs créent une dette de réputation. Vos meilleurs utilisateurs apprennent à s’autocensurer, ou déplacent la conversation ailleurs.
- Les faux positifs créent de la confusion en interne. Les équipes sales, partenariats et communauté n’arrivent plus à expliquer ce que fera le produit, parce que le produit n’est plus prévisible.
Quand je dirigeais une business unit internationale en smart building et home automation, la fiabilité ne se limitait jamais au hardware. Nos capteurs et contrôles connectés n’étaient « bons » que si les clients pouvaient anticiper le comportement entre edge devices, cloud et support. La modération relève du même type de problème de fiabilité. Le modèle n’est qu’un composant. Le système, c’est le produit.
Définir le budget d’erreur en termes business, simples
Un budget d’erreur n’est pas une métrique de recherche. C’est un contrat business : combien d’actions injustifiées vous acceptez par jour ou par semaine avant d’arrêter la ligne.
Je préfère définir les budgets à trois niveaux :
- Budget de préjudice utilisateur. Nombre maximal de suspensions injustifiées, suppressions injustifiées ou blocages injustifiés autorisés sur une période donnée. Un pourcentage ne suffit pas : le volume absolu compte, parce que l’impact se concentre en grappes.
- Budget opérationnel. Nombre maximal d’appels que vous pouvez traiter dans le SLA promis, et âge maximal du backlog.
- Budget de réputation. Nombre maximal d’échecs très visibles (par exemple, des actions injustifiées contre des utilisateurs historiques, des comptes vérifiés ou des clients payants) avant de déclencher une revue au niveau exécutif.
Ensuite, rendez-le exécutable. Tout budget doit inclure :
- De l’instrumentation. On ne pilote pas ce qu’on ne mesure pas. Logguez chaque décision avec la version du modèle, la version de la policy, les features, le niveau de confiance et l’action d’enforcement.
- Des seuils qui déclenchent des actions. À 50 % du budget, vous resserrez le rollout. À 100 %, vous figez. Au-delà, vous rollback.
- Un propriétaire unique. Pas un comité. Un opérateur accountable, capable d’arrêter la ligne.
C’est le même schéma que j’ai utilisé plus tard quand j’ai reconstruit et fait grandir une organisation R&D. On peut débattre de la qualité toute la journée. Ou définir un budget, le mesurer et forcer l’organisation à réagir quand il est dépassé.
Déployer avec shadow evaluation et des conditions d’arrêt explicites
La plupart des échecs en modération ne sont pas « le modèle était imparfait ». C’est plutôt : « on a déployé sans montée en charge contrôlée, sans shadow evaluation, et sans bouton d’arrêt que quelqu’un était prêt à actionner ».
En environnement industriel, on ne confie jamais des résultats à l’automatisation dès le premier jour. On la fait tourner en parallèle et on la compare au process de référence jusqu’à ce qu’elle soit digne de confiance. Cet état d’esprit s’applique très bien à la modération par l’IA :
- Shadow mode d’abord. Le modèle prend des décisions, mais des humains ou le moteur de règles actuel restent la source de vérité. Vous mesurez les écarts et vous analysez les principaux clusters d’erreurs.
- Rollout sous contrôle. Commencez par des actions à faible sévérité (étiquetage, déréférencement, friction). Ne démarrez pas par des actions irréversibles (suspensions, bans) si vous ne pouvez pas les annuler en quelques minutes.
- Conditions d’arrêt avant le lancement. Écrivez-les. « Si les suspensions injustifiées dépassent X sur 24 heures, rollback. » « Si les appels dépassent le SLA pendant Y heures, on gèle tout nouvel enforcement. »
- Change control. Traitez les mises à jour du modèle comme des releases de production. Versionnez tout. Si vous ne pouvez pas répondre à « qu’est-ce qui a changé ? », vous ne pouvez pas faire de gestion d’incident.
Boards et propriétaires devraient poser une question qui coupe court à tout le reste : quelles sont les conditions d’arrêt, et qui a l’autorité pour les déclencher ?
Cela rejoint directement ma conviction plus générale : la valeur de l’IA est opérationnelle, pas organisationnelle. J’en ai écrit davantage ici : AI Value Isn’t in the Org Chart. It’s in the Stop Button.
Le kill switch est une fonctionnalité produit, pas un bricolage en incident
Un kill switch, ce n’est pas « on peut l’éteindre si besoin ». Ça, c’est un espoir. Un kill switch, ça se conçoit.
En pratique, vous voulez au moins quatre switches, chacun avec un périmètre d’impact clair :
- Arrêt global de l’enforcement. Le modèle peut continuer à scorer le contenu, mais ne peut plus agir.
- Arrêt par classe d’action. Désactiver uniquement les actions les plus sévères (par exemple, les suspensions) tout en gardant les interventions plus « douces ».
- Arrêt par segment de policy. Désactiver une zone de policy problématique (par exemple, la détection de contenu adulte) sans toucher au reste.
- Rollback de version du modèle. Revenir instantanément à la version précédente, connue comme fiable, y compris prompts, seuils et pipelines de features.
Tout se joue sur la vitesse et la confiance. Si un rollback prend des heures, vous hésiterez. Et si vous hésitez, l’incident enfle. En fabrication, c’est comme ça que la casse s’accumule. En SaaS, c’est comme ça que le churn s’accumule.
Quand je dirigeais des opérations en électrification et en energy storage, les conditions d’arrêt n’étaient pas théoriques. Si vous suspectez une dérive de process, vous arrêtez, vous confinez, vous vérifiez. Vous n’attendez pas la réunion hebdomadaire. La modération doit avoir les mêmes réflexes, même si le « produit » est numérique.
Les appels ne sont pas du support : c’est votre boucle de calibration
Un workflow d’appel est souvent vu comme un centre de coûts. En réalité, c’est un système qualité. C’est ce qui vous permet de détecter la dérive, les ambiguïtés de policy et les angles morts du modèle.
Concevez-le comme un mécanisme de recours avec de vraies garanties :
- Rétablissement rapide pour les erreurs très probables. Si votre système qualifie une action de faible confiance, orientez-la vers une revue avant enforcement, ou rétablissez automatiquement quand un appel arrive.
- Délais visibles. Les utilisateurs acceptent plus facilement des règles strictes que des résultats imprévisibles. Publiez des SLA, puis respectez-les.
- Feedback structuré. Chaque décision annulée doit produire un point de donnée labellisé, rattaché à la clause exacte de la policy et à la version exacte du modèle.
- Nettoyage post-incident. Si vous rollback un modèle, auditez aussi les N dernières actions et rétablissez proactivement les comptes lorsque la confiance était faible ou que le cluster d’erreur est connu.
En venture building, j’applique la même logique. Chez Shopeno et IBHQ, je ne traite pas les plaintes utilisateurs comme du bruit. Je les considère comme un signal sur des trous dans le process. Les appels sont ce signal, à l’échelle, à condition de bien les capter.
Checklist « prête pour le trimestre » pour opérateurs et boards
Si vous êtes responsable d’une plateforme avec de la modération par l’IA, voici ce que je mettrais en place ce trimestre.
- Écrire le budget de dommages. Volumes absolus par jour pour les suppressions injustifiées et les suspensions injustifiées. Avec seuils et actions associées.
- Instrumenter les décisions de bout en bout. Version du modèle, version de la policy, niveau de confiance, features, et résultat d’enforcement.
- Lancer une shadow evaluation. Mesurer les écarts face à la revue humaine ou au système actuel, jusqu’à comprendre les principaux clusters d’erreurs.
- Mettre l’enforcement en étapes. Commencer par des actions réversibles, puis monter vers l’irréversible uniquement avec une vitesse de recours démontrée.
- Concevoir quatre kill switches. Arrêt global, arrêt par classe d’action, arrêt par segment de policy, et rollback de version du modèle.
- Mettre en production un SLA d’appel. Le rendre visible. Le financer. Utiliser les cas annulés comme données de calibration.
- Définir la responsabilité en incident. Un opérateur accountable, une rotation on-call, un playbook.
C’est de la discipline opérationnelle. La même discipline derrière tout contrat de fiabilité, que vous livriez des contrôleurs industriels, des capteurs connectés ou une plateforme SaaS. Si vous voulez un cadrage connexe issu du monde physique, ma position est cohérente avec Ruggedization Isn’t a Checkbox. It’s a Reliability Contract You Pay For and Enforce.
Mon avis : traiter la modération comme de l’automatisation, ou ne pas l’automatiser
La modération par l’IA fera toujours des erreurs. La question est de savoir si votre organisation est conçue pour détecter, contenir et inverser ces erreurs avant qu’elles ne deviennent des dommages utilisateurs à grande échelle.
Les bonnes intentions ne créent pas la sécurité. Les systèmes de contrôle, si. Si vous ne pouvez pas exprimer votre budget de dommages, montrer vos conditions d’arrêt et rétablir rapidement les utilisateurs, vous n’opérez pas de la modération par l’IA. Vous jouez votre base clients.
Ne mettez le modèle en production qu’après avoir mis en production le plan de contrôle.
Newsletter
Des notes de terrain, directement dans votre boîte.
Des notes occasionnelles et sans bruit, prises de l'intérieur du travail : ce qui a été livré, ce qui a cassé, et ce que je ferais différemment.