29 octobre 2026 · 8 min de lecture
Votre pilote IoT n’a pas échoué. Ce sont vos coutures qui ont lâché.
Faire passer des produits connectés à l’échelle relève surtout du contrat et de la discipline terrain. Le code sert de coupable de dernière minute.
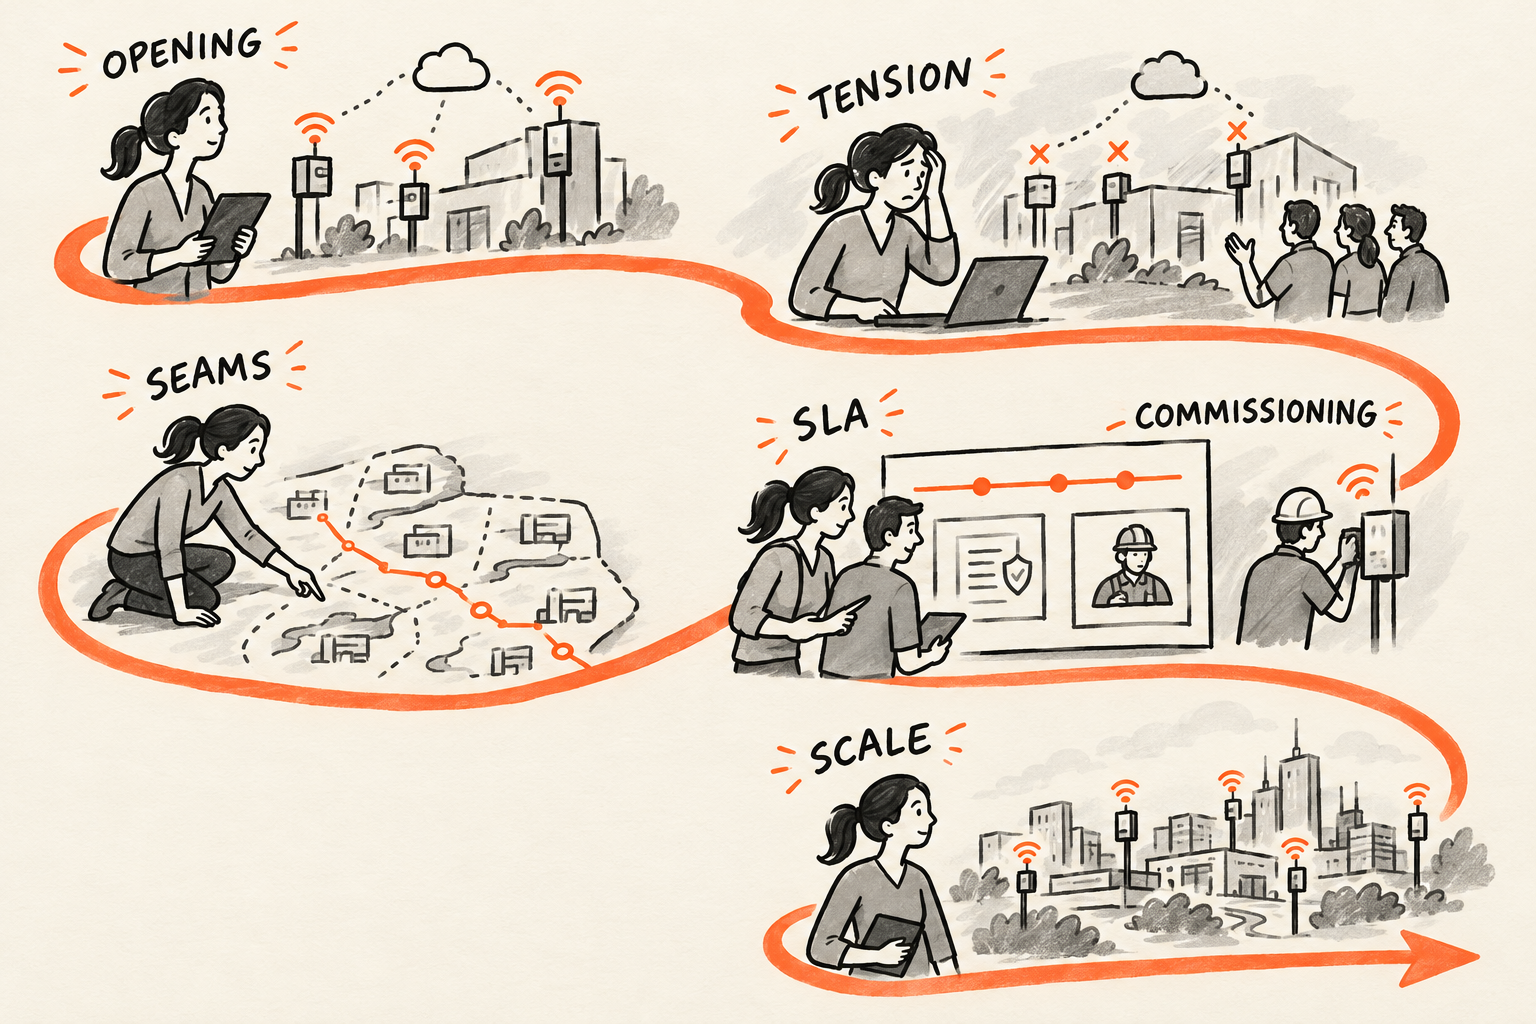
Presque tous les pilotes IoT ont l’air en bonne santé dans une salle de démo.
L’appairage fonctionne. Le dashboard se met à jour. Quelques alertes remontent. Tout le monde acquiesce, et quelqu’un prononce la phrase dangereuse : « Maintenant, passons à l’échelle. »
Puis le premier vrai déploiement démarre, et le même scénario se répète. Un site a une connectivité faible. Un équipement nécessite une mise à jour firmware. Un client demande qui garantit la disponibilité. Une unité se retrouve bricked. Le support ouvre un ticket, qui rebondit entre « l’équipe cloud », « l’équipe app », l’installateur et le fournisseur hardware. Chacun a raison sur son périmètre. Le client, lui, est toujours à l’arrêt.
C’est pour cela que ce livre blanc d’IoT Now met le doigt sur la vérité la plus reproductible des produits connectés : les pilotes échouent aux coutures, pas dans le code.
Ma conviction est simple : si vous ne pouvez pas désigner un responsable clairement redevable du commissioning, et un responsable clairement redevable du SLA client de bout en bout, vous n’avez pas encore un produit. Vous avez un projet scientifique avec des factures en prime.
Les coutures : l’endroit où la responsabilité disparaît
Quand on dit « l’IoT, c’est compliqué », on veut souvent dire : « cela touche trop d’équipes ». C’est vrai, mais insuffisant. Le vrai mode d’échec, ce sont des passations mal définies, ou pire : « partagées ». Partagé, c’est là où les délais viennent mourir.
Le livre blanc pointe les zones de tension classiques : la responsabilité des mises à jour firmware, la disponibilité du cloud et les contrats de données, et le modèle de service lorsqu’un device se retrouve bricked sur le terrain. Ce ne sont pas des détails techniques. Ce sont des contrats d’interface entre des personnes et des entreprises.
Voici la vérité inconfortable que j’ai apprise en construisant des systèmes de pilotage de bâtiments connectés : passer à l’échelle, c’est surtout concevoir des contrats et imposer une discipline terrain. La technologie est rarement le facteur limitant. Elle devient simplement le bouc émissaire quand les angles commerciaux et de service ont été laissés flous.
Pour un diagnostic rapide, posez ces questions et observez à quelle vitesse la salle se met à négocier :
- Qui a le droit de pousser une mise à jour firmware, et qui est tenu pour responsable si cela interrompt un site ?
- Que promet exactement la disponibilité du cloud, et est-ce formulé dans le langage du client ou dans celui du fournisseur ?
- Qui possède l’identité et le provisioning du device, et que se passe-t-il quand un installateur coupe les angles pour finir sa journée ?
- Quel est le processus terrain quand une unité est bricked, volée, remplacée, ou simplement hors service ?
Si une réponse commence par « ça dépend » ou se termine par « on verra », votre pilote n’est pas prêt à sortir du labo.
Un seul responsable du commissioning, sinon chaque site devient un projet sur mesure
Le mensonge le plus coûteux en mise à l’échelle IoT consiste à appeler le commissioning « installation ». « Installation » suggère une tâche ponctuelle. Le commissioning, c’est un système qui prend vie dans le monde réel, dans des conditions imparfaites, avec des critères d’acceptation qui déterminent qui est payé et qui est sanctionné.
Le point pratique du livre blanc est celui que je voudrais voir davantage d’équipes prendre au sérieux : désigner un responsable unique du commissioning, avec autorité sur l’installateur, la connectivité, l’identité device et les critères d’acceptation. Sans cela, chaque déploiement devient un projet spécifique, et votre marge s’évapore en déplacements, reprises et escalades.
Ce responsable n’est pas un chef de projet avec un joli diagramme de Gantt. Il doit avoir le droit de dire :
- « Nous n’acceptons pas ce site : la connectivité ne respecte pas le minimum. »
- « On ne passe pas en production tant que le provisioning n’est pas automatisé et traçable. »
- « Voici les tests d’acceptation, et nous les exécuterons partout de la même manière. »
Quand le commissioning est faible, votre rollout devient une collection d’exceptions. Les exceptions se multiplient. Puis l’ingénierie est happée par les incendies terrain, et la roadmap se transforme en cimetière.
Pour un modèle mental : considérez le commissioning comme une surface produit, pas comme une tâche de delivery. Il lui faut une spec, une toolchain et un responsable unique.
La décision qui évite de faire du logiciel le bouc émissaire
Si je ne pouvais imposer qu’une décision avant tout déploiement, ce serait celle-ci : définir, noir sur blanc, qui porte le SLA client de bout en bout.
Le livre blanc le dit clairement : ne définissez pas la responsabilité par composants. Dire « la disponibilité cloud relève de l’équipe plateforme » et « la fiabilité device relève du fournisseur hardware » paraît propre sur le papier. Dans la vraie vie, les incidents ne respectent pas les organigrammes.
La plupart des histoires d’indisponibilité dans les produits connectés ressemblent à ceci :
- Le device fonctionne, mais n’atteint plus le cloud à cause d’un changement réseau sur site.
- Le cloud va bien, mais des certificats device ont expiré à cause d’un angle mort dans le cycle de vie.
- L’app fonctionne, mais une mise à jour firmware a introduit une boucle de démarrage rare sur le terrain.
Chaque propriétaire de composant a des arguments. Le système, lui, continue de décevoir la personne qui paie.
Un responsable du SLA de bout en bout déplace la conversation de « qui a raison » vers « qu’est-ce qui rétablit le service le plus vite ». Cela force aussi les bons choix d’ingénierie en amont : observability, chemins de rollback, rollouts progressifs, et tout le travail peu glamour qui évite des incidents de plusieurs jours.
Si vous avez déjà opéré un service sérieux, vous connaissez la conclusion : les clients n’achètent pas votre architecture. Ils achètent le résultat, et la réponse quand cela casse.
Une checklist kill-or-scale qui évite vraiment le théâtre du rollout
Les pilotes meurent souvent à petit feu parce que personne ne veut dire « stop ». Ils deviennent permanents : quelques sites, beaucoup d’attention, et juste assez de succès pour entretenir l’espoir.
Je préfère une bifurcation nette : on arrête, ou on passe à l’échelle. Le livre blanc propose le même remède : utiliser une checklist qui force l’assignation des responsabilités.
Voici la version que je mettrais devant une équipe de direction. Si vous ne savez pas répondre, vous ne déployez pas. Non pas parce que la tech est mauvaise, mais parce que vous êtes sur le point de créer une catastrophe support.
1) Carte des coutures (écrivez-la)
- Firmware : qui peut déployer, comment vous cadenciez, comment vous faites rollback, qui valide les correctifs d’urgence.
- Cloud : cible de disponibilité, fenêtres de maintenance, rétention des données, accès aux données, communication en incident.
- Identity : flux de provisioning, rotation des certificats, processus de remplacement d’un device.
- Field service : qui remplace le hardware, délais, ce qui est facturable, ce qui relève de la garantie.
Si une couture est « partagée », corrigez-la. « Partagé » signifie que personne n’est responsable quand cela fait mal.
2) Autorité de commissioning (un nom)
- Elle possède les critères d’acceptation et le playbook de commissioning.
- Elle peut bloquer un go-live si les prérequis ne sont pas respectés.
- Elle maîtrise l’interface installateur, y compris la formation et l’audit.
3) SLA de bout en bout (un responsable)
- Un seul chemin d’escalade côté client.
- Un seul incident commander pour les pannes prioritaires.
- Des contrats internes clairs avec chaque équipe composant ou fournisseur.
4) Les cas désagréables (décidez avant qu’ils n’arrivent)
- Que se passe-t-il quand un device est bricked ?
- Que se passe-t-il quand la connectivité est instable ?
- Que se passe-t-il quand un installateur s’écarte du standard ?
- Que se passe-t-il quand le client refuse une mise à jour firmware ?
Ce ne sont pas des cas limites. C’est un mardi.
5) Un déclencheur de mise à l’échelle (pas au feeling)
- Définissez ce que signifie le « succès du pilote » en termes mesurables : stabilité, temps de commissioning reproductible, charge support et disponibilité.
- Fixez le seuil qui déclenche l’investissement de rollout, et celui qui met fin au programme.
C’est là que la plupart des équipes trichent. Elles traitent une démo comme une preuve. Votre seule preuve, c’est la répétabilité dans des conditions terrain normales.
Mon avis : l’IoT est un business de service qui se donne des airs de business produit
Les produits connectés vivent dans le monde. Et le monde est imparfait. Ce désordre doit être tarifé, contractualisé et pris en charge.
Donc oui, le logiciel compte. Mais ce n’est pas votre risque principal. Votre risque principal, c’est de livrer quelque chose qu’on ne peut pas commissionner de façon constante, qu’on ne peut pas mettre à jour en sécurité, et qui ne porte pas une promesse claire de bout en bout au client.
Si vous ne deviez retenir qu’une chose : avant de passer à l’échelle, partez à la chasse aux coutures. Donnez un owner à chacune. Puis mettez un responsable au-dessus, redevable du résultat pour le client.
C’est ainsi que vous évitez que les pilotes meurent poliment. Et c’est ainsi que vous construisez une technologie qui change réellement quelque chose pour ceux qui vivent avec.
Si vous êtes précisément en train de passer de quelques sites pilotes à un vrai rollout, la lecture de Autonomy’s Hard Part Isn’t the Car. It’s the Service. peut aussi vous aider. La forme du problème est la même : le dur commence après la démo.
Newsletter
Des notes de terrain, directement dans votre boîte.
Des notes occasionnelles et sans bruit, prises de l'intérieur du travail : ce qui a été livré, ce qui a cassé, et ce que je ferais différemment.