26 October 2026 · 9 min de lecture
Le ruggedization n’est pas une case à cocher. C’est un contrat de fiabilité que vous financez et que vous faites respecter.
Si « rugged » n’est pas traduit en contraintes quantifiées, en modes de défaillance et en responsabilité claire des tests, vous livrerez des gagnants de laboratoire qui meurent sur le terrain.
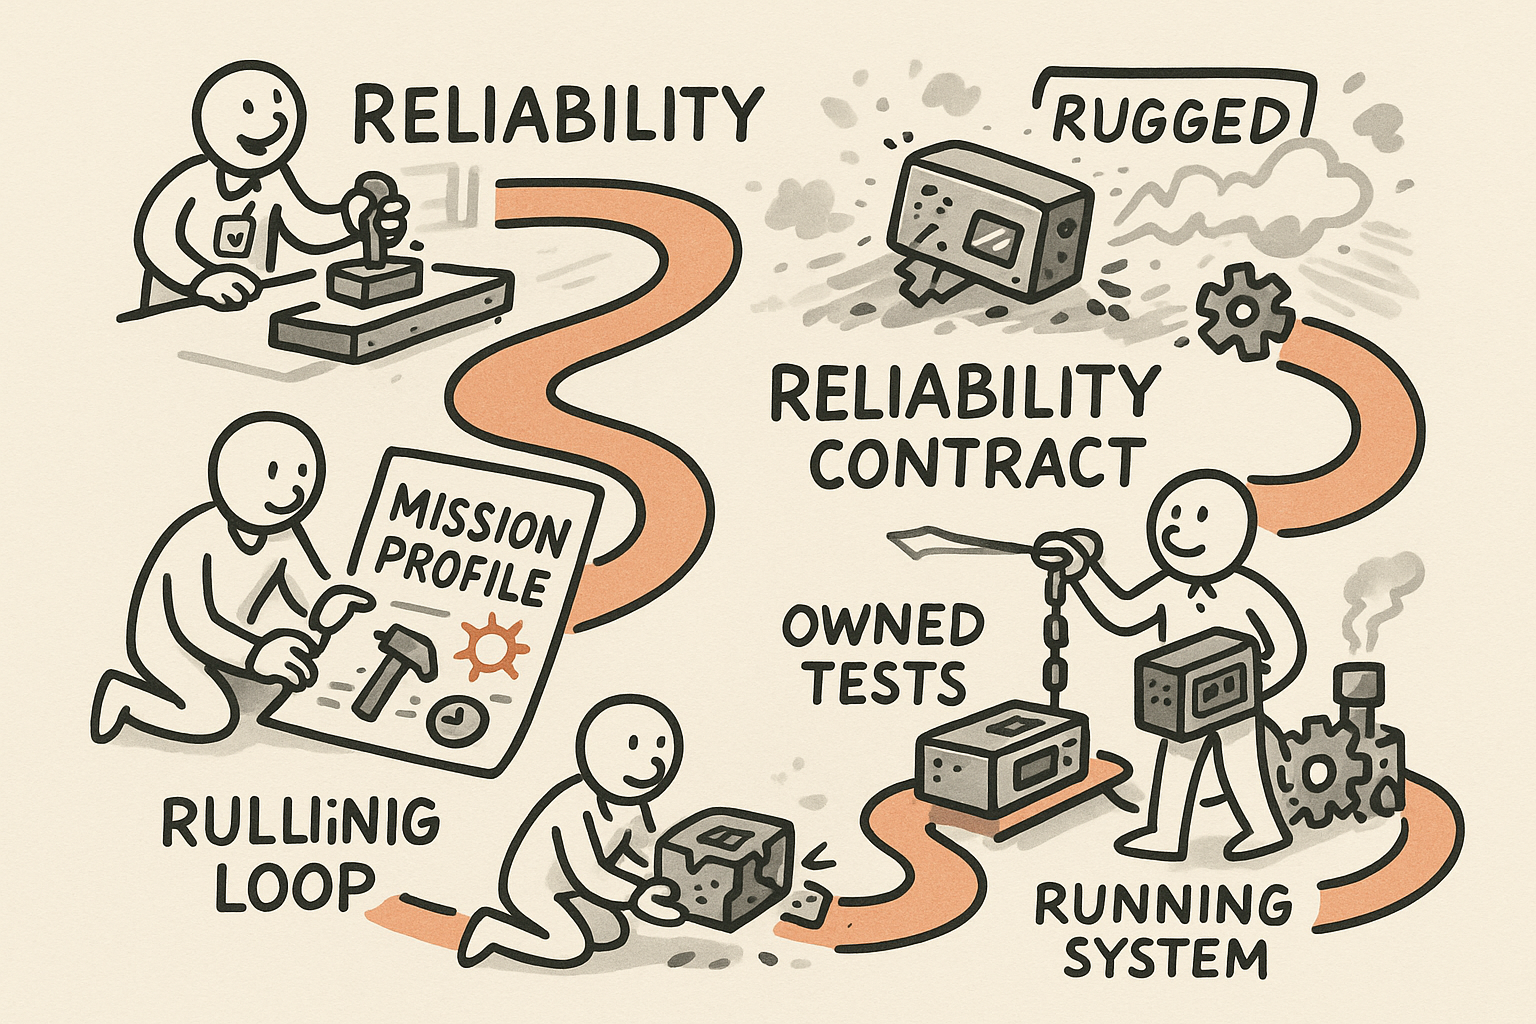
J’ai vu trop de programmes rejouer le même scénario, toujours aussi douloureux : un produit passe sa qualification dans un laboratoire propre, tout le monde se félicite, puis la réalité rattrape l’équipe. L’unité est installée dans un environnement plus agressif, manipulée par un autre technicien, montée d’une manière légèrement différente, soumise à un duty cycle que personne n’a formalisé, et elle commence à tomber en panne. L’analyse post-mortem retombe presque toujours sur la même cause racine. Pas la « malchance ». Pas même des « mauvaises pièces ». La cause racine, c’est souvent la gouvernance. « Rugged » était un mot, pas un contrat.
Lorsque j’ai piloté pendant des années la qualité marché en électronique de puissance, puis plus tard la R&D et les opérations pour des dispositifs connectés et des systèmes industriels, j’ai appris à traiter la fiabilité comme un coût. Si elle n’est pas quantifiée, portée par un responsable et appliquée de bout en bout, elle devient un théâtre. Les équipes optimisent le passage en labo, parce que c’est ce que le système récompense. Les clients paient pour l’uptime et la durée de vie sur le terrain, pas pour des certificats.
Le ruggedization ne consiste pas à tout rendre « MIL-spec ». Cette approche est à la fois coûteuse et paresseuse. Le rôle de l’opérateur est de décider où durcir, où revoir la conception, et où accepter un risque — puis de le démontrer par des tests qui reflètent le profil de mission réel. Le reste n’est qu’un pari, avec une belle couverture PowerPoint.
1) Partir d’un profil de mission, pas d’un adjectif
« Rugged » n’est pas une exigence. C’est un raccourci pour désigner un ensemble de contraintes dans le temps. Si vous ne les posez pas par écrit, l’ingénierie devinera, les tests supposeront, les achats substitueront, et la production dérivera. Chacun sera rationnel localement. Et vous serez en échec globalement.
Un profil de mission doit être suffisamment explicite pour que deux équipes sur deux continents aboutissent au même design et au même plan de tests. Concrètement, je veux qu’il soit formulé comme environnement + usage, puis traduit en sollicitations mesurables :
- Environnement : plage et gradients de température, humidité et épisodes de condensation, spectre vibratoire, chocs, poussières, chimie, UV, brouillard salin, altitude, exposition CEM.
- Usage : duty cycle, cycles d’alimentation, fréquence de commutation, nombre d’actionnements mécaniques, cycles d’accouplement des connecteurs, couple de serrage à l’installation, intervalle de maintenance, fréquence des mises à jour firmware.
- Contraintes : indisponibilité acceptable, maintenabilité, stratégie de pièces de rechange, besoins de calibration, dérive acceptable, horizon de garantie.
Puis j’impose l’étape suivante : traduire le profil en modes de défaillance quantifiés. Qu’est-ce qui casse en premier, et pourquoi, sous ces contraintes ? Est-ce la fatigue des soudures due aux cycles thermiques, le fretting des connecteurs sous vibration, l’infiltration d’humidité et la corrosion, le fluage des polymères, le délaminage d’un coating, le dessèchement de condensateurs électrolytiques, ou un watchdog logiciel qui interagit avec des brownouts ? C’est là que le « ruggedization » cesse d’être une posture et devient une décision d’ingénierie et de pilotage.
En tant qu’ex-COO responsable de l’ingénierie, de la production et du service dans l’électrification et le stockage d’énergie, je me souciais moins de l’étiquette d’un composant que du modèle de durée de vie du système. Certaines pièces doivent être surdimensionnées. D’autres nécessitent une isolation mécanique. D’autres encore demandent de revoir la circulation d’air, l’étanchéité ou l’empilage PCB. Et parfois, la bonne réponse consiste à resserrer l’enveloppe d’utilisation et à l’inscrire dans le contrat.
2) Mettre une personne aux commandes de la fiabilité, avec une vraie autorité
La plupart des pannes terrain ne viennent pas d’un manque de compétence. Elles viennent d’interfaces sans propriétaire : l’ingénierie suppose que les tests vont le voir, les tests supposent que les exigences sont justes, la qualité suppose que les fournisseurs respectent, les fournisseurs supposent que les substitutions sont acceptables. Personne n’est vraiment responsable, donc personne ne referme la boucle.
La correction est simple et inconfortable : nommer un unique responsable de la fiabilité. Pas un comité. Un leader redevable, qui tient trois leviers :
- Hypothèses d’environnement : le profil de mission est figé et versionné. Tout changement déclenche une revue d’impact.
- Matrice de tests : quelles contraintes, dans quel enchaînement, quelle logique de taille d’échantillon, quels critères de réussite/échec, quelles marges.
- Règles d’acceptation : ce qui rend un design libérable, quelles dérogations existent, et ce qui doit être corrigé avant la montée en cadence.
Quand j’ai reconstruit et fait grandir une organisation R&D couvrant embedded software, cloud, électronique, mécanique et QA, l’amélioration la plus rapide sur la fiabilité est venue de la clarté. Pas de « plus de tests ». Une responsabilité nette et une définition unique de « done ». Une fois la fiabilité portée par un responsable, les résultats de labo ont cessé d’être une fin en soi : ils sont devenus un passage obligé vers le cycle d’apprentissage suivant.
Donnez à ce responsable du pouvoir sur les priorités et le change control. Sinon, vous lui demandez d’assumer des résultats sans maîtriser les entrées. Ce n’est pas de la responsabilité. C’est du théâtre.
3) Choisir ce que vous ruggedizez, ce que vous redesigniez et ce que vous operationalizez
« Rendez-le rugged » sert souvent à éviter une décision plus difficile : où met-on de l’argent, du délai et de la complexité, et où change-t-on plutôt le design système ou le modèle opérationnel ?
J’utilise une grille simple, applicable par un board et par des équipes opérationnelles en revue trimestrielle. Pour chaque mode de défaillance majeur, choisissez l’une des trois stratégies :
- Ruggedizer le composant : surdimensionner, changer de matériaux, ajouter un coating, ajouter une retenue mécanique, renforcer l’étanchéité. Cela augmente le coût unitaire et souvent les délais, mais peut aller vite si l’architecture s’y prête.
- Redesign du système : déplacer les sources de chaleur, revoir l’implantation pour réduire les écarts de CTE, ajouter de l’isolation, reprendre creepage et clearance, ajouter de la redondance, changer la stratégie de connecteurs, améliorer drainage et ventilation. Cela consomme du temps d’ingénierie, mais peut réduire le coût récurrent et simplifier le risque supply.
- Operationalizer le risque : limiter l’enveloppe, imposer des contraintes d’installation, exiger des intervalles de service, ajouter du monitoring, ajouter du stress-screening en production, ou adapter packaging et logistique. C’est souvent la voie la moins chère si le contexte client le permet.
L’erreur consiste à faire les trois, sans discernement. Vous obtenez un produit surconstruit, qui reste fragile parce que la contrainte réelle n’a jamais été modélisée. Ou vous sous-construisez et vous essayez de rattraper au budget garantie.
Sur des capteurs connectés et des systèmes de contrôle de bâtiments, par exemple, j’ai vu comment une variabilité d’installation « marginale » devient un moteur de défaillance : traction sur câble, condensation derrière une cloison, vibrations d’un compresseur voisin, ou qualité d’alimentation. Parfois, le ruggedization était la bonne option. D’autres fois, la décision gagnante était un redesign mécanique et des règles d’installation claires, appliquées par la formation et des contrôles d’acceptation.
4) Traiter les recettes process comme des composants critiques, parce que c’en sont
Les équipes traitent souvent la nomenclature (BOM) comme intangible et le process comme flexible. Sur des produits rugged, c’est l’inverse. Coatings, composites, adhésifs, résines de potting, profils de polymérisation, préparation de surface, fenêtres de refusion, couples de serrage, étapes de nettoyage : ce ne sont pas des « détails de fabrication ». Ce sont des fonctions de fiabilité.
La qualification fournisseur ne peut donc pas s’arrêter à une datasheet. Le playbook opérateur est le suivant :
- Verrouiller la recette : spécifier la qualité matière, le ratio de mélange, la préparation de surface, le temps et la température de cure, et la fenêtre d’humidité admissible. Documentez-la comme une spécification composant.
- Auditer la ligne : vérifier que le fournisseur sait mesurer et piloter la recette, pas seulement l’affirmer. S’il ne peut pas mesurer, il ne peut pas contrôler.
- Contrôler les sous-traitants de rang inférieur : préciser ce qui exige notification et ce qui impose une requalification. Un changement de source de résine, de lot de coating, de stratifié PCB, de pâte à braser ou de chimie de nettoyage peut changer la durée de vie terrain.
- Rendre les écarts coûteux : pas en euros, mais en friction. Les écarts déclenchent une revue formelle, des tests additionnels et un décalage de release. Les gens respectent les règles quand elles ont des dents.
Lorsque je dirigeais une business unit internationale, avec des produits expédiés dans plusieurs pays, j’ai appris que les substitutions non maîtrisées tuent en silence. Les achats sont récompensés sur le coût et la continuité. La production est récompensée sur le volume. Sans contrat de fiabilité appliqué via le change control, les deux prendront des décisions « raisonnables » qui effacent vos marges sur le terrain.
5) Fermer la boucle avec les données terrain et des déclencheurs de stress-screening
Le ruggedization n’est pas un projet ponctuel. C’est un système d’apprentissage. Si vous ne récupérez pas les retours terrain et ne les réinjectez pas dans les règles de conception, les contrôles fournisseurs et le screening, vous paierez indéfiniment la même leçon.
J’aime piloter une boucle courte, avec trois composantes :
- Un triage rapide des retours terrain : classer les pannes par mécanisme, pas par symptôme. « Pas d’alimentation » est un symptôme. « Fissure d’une soudure sur le condensateur du DC link due aux cycles thermiques » est un mécanisme.
- Des déclencheurs de stress-screening : décider quels signaux précoces déclenchent un screening renforcé en production (burn-in, cycles thermiques, vibration screening, exposition à l’humidité). Ne screenez pas indéfiniment par défaut. Screenez quand les données le justifient, et arrêtez quand le process est sous contrôle.
- Mises à jour design et process : transformer les apprentissages en critères d’acceptation et contrôles process fournisseurs mis à jour, puis faire respecter via une discipline ECO.
C’est ici que beaucoup d’organisations échouent culturellement. Elles considèrent les retours comme un centre de coûts, pas comme une entrée du modèle de fiabilité. Dans mes ventures de plateformes SaaS comme Shopeno et IBHQ, la boucle de feedback saute aux yeux, car la télémétrie est continue. Sur du hardware, il faut la construire volontairement. Mais le principe est identique : si le système n’apprend pas, la dépense de fiabilité devient une taxe récurrente, sans bénéfice cumulatif.
Ce que je demanderais au prochain board meeting
Si vous voulez une manière concrète de gouverner le ruggedization ce trimestre, demandez au management d’apporter un contrat de fiabilité d’une page pour chaque ligne produit :
- Profil de mission : contraintes et hypothèses d’usage explicites, versionnées.
- Top 5 des modes de défaillance : au niveau mécanisme, avec le niveau de preuve actuel.
- Stratégie retenue par mode de défaillance : ruggedize, redesign ou operationalize, avec impact coût et lead time.
- Responsable fiabilité : une personne nommée, avec autorité sur la matrice de tests et l’acceptation.
- Contrôles fournisseurs et process : recettes verrouillées et déclencheurs de changement.
- Boucle d’apprentissage terrain : cadence d’analyse des retours et triggers de screening.
Ma position est simple : le ruggedization n’est ni une case à cocher ni une promesse marketing. C’est un contrat de fiabilité exécutoire, qui couvre l’ingénierie, les tests, les fournisseurs, la fabrication et le service. Si vous ne le pilotez pas comme un contrat, vous le paierez deux fois : une première fois en pièces coûteuses, et une seconde fois sur le terrain.
Newsletter
Des notes de terrain, directement dans votre boîte.
Des notes occasionnelles et sans bruit, prises de l'intérieur du travail : ce qui a été livré, ce qui a cassé, et ce que je ferais différemment.