26 October 2026 · 7 min de lecture
Les capteurs connectés n’achètent pas votre uptime. La discipline d’exploitation, si.
La télémétrie n’a d’intérêt que si elle devient du travail clairement attribué, des décisions économiques et une boucle fermée entre signal et correctif.
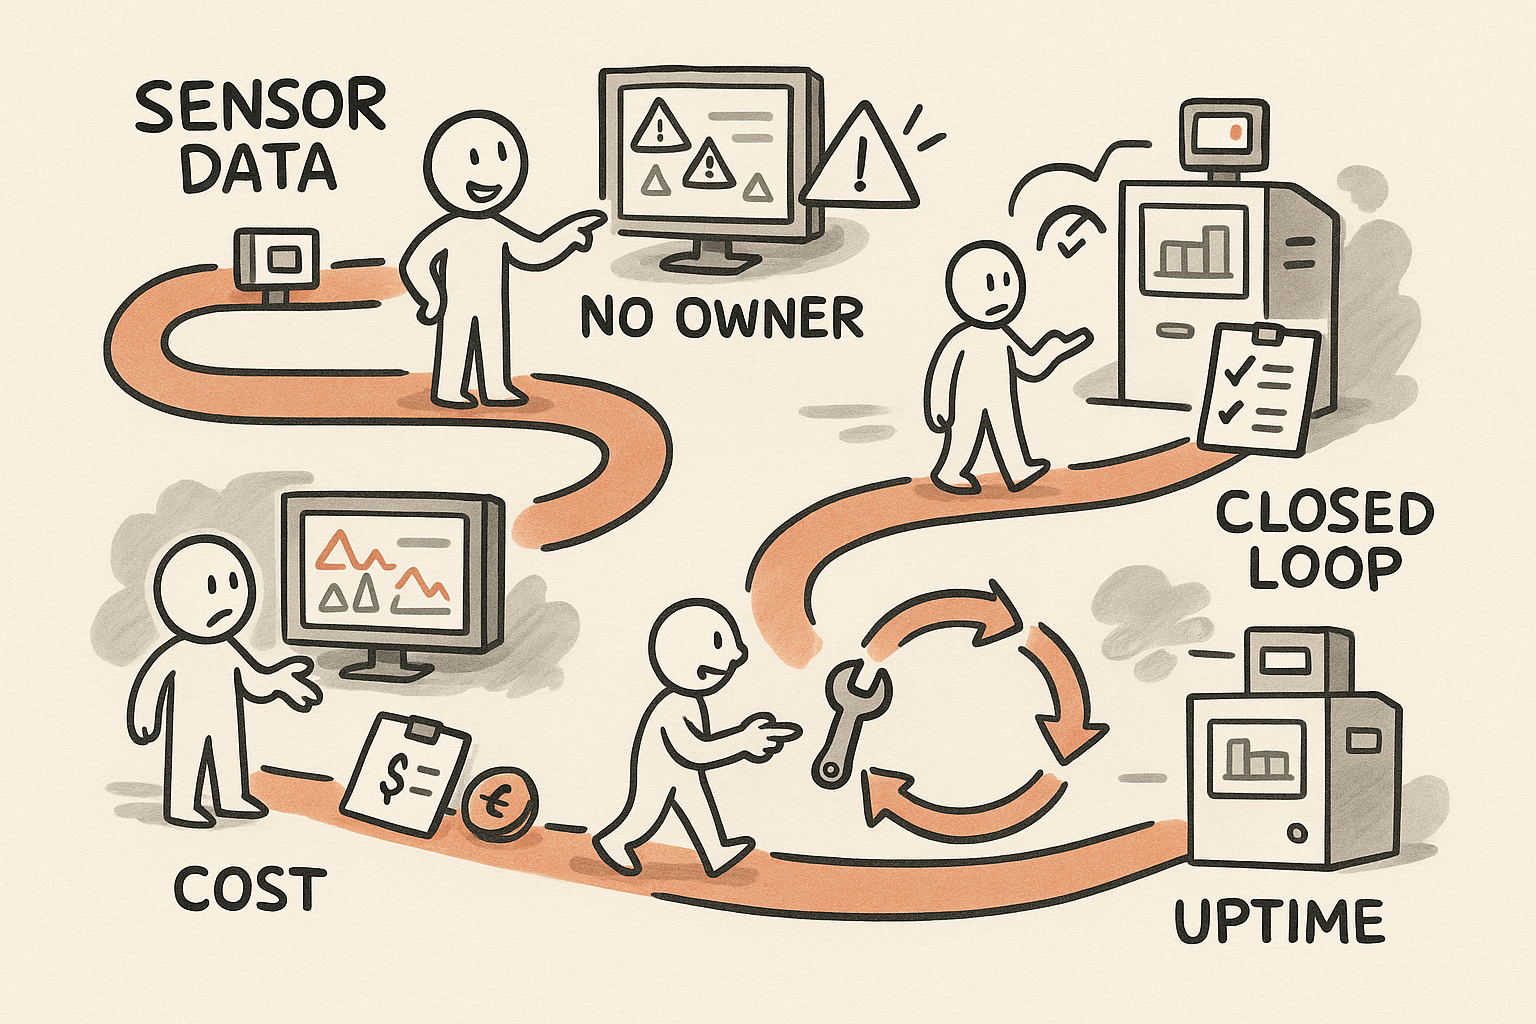
J’ai livré des produits connectés, et j’ai aussi assumé les conséquences opérationnelles quand ils ne tenaient pas leurs promesses. Le schéma est récurrent : des équipes achètent de la télémétrie et appellent cela de la « maintenance digitale ». Puis l’uptime ne bouge pas, et tout le monde accuse le modèle, le cloud ou la culture du site.
Ma lecture est plus simple — et plus inconfortable. Les capteurs connectés ne vous achètent pas de l’uptime. La discipline d’exploitation, si.
Quand je dirigeais une business unit de smart building avec une responsabilité P&L complète, nous avons conçu et vendu des capteurs et des contrôleurs connectés dans plusieurs pays. La technologie fonctionnait. Les données remontaient. Les dashboards étaient impeccables. Pourtant, les résultats dépendaient presque entièrement de la capacité des clients (et de nos propres équipes service) à transformer les signaux en actions prises en charge, avec une économie claire et des boucles de retour serrées. Plus tard, quand j’ai piloté des opérations dans l’électrification et le stockage d’énergie entre le Danemark et l’Ukraine, le même principe s’est imposé : la fiabilité est un operating system, pas une fonctionnalité.
Oui, la supervision à distance peut soutenir une maintenance proactive et réduire les arrêts, comme l’explique l’article de Manufacturing Dive sur les capteurs connectés et le monitoring en temps réel au service d’une maintenance proactive. Je suis d’accord. Mais, dans cette phrase, le « peut » porte presque tout. Il ne manque pas plus de capteurs. Il manque ce que vous faites après l’alerte.
Le vrai mode d’échec : de la télémétrie sans owner
La plupart des programmes capteurs meurent à l’un des trois endroits suivants :
- Personne n’est véritablement comptable. La maintenance possède les actifs, l’IT possède le réseau, l’ingénierie possède la spécification, l’exploitation possède la production. L’alerte arrive dans la boîte de tout le monde — et dans les mains de personne.
- Aucun seuil économique. Les équipes traitent chaque anomalie comme urgente, puis finissent en « alert fatigue ». Ou elles ignorent tout jusqu’à la panne, puis concluent que les capteurs « ne l’avaient pas prédite ».
- Pas de boucle fermée. Même quand un technicien intervient, le résultat ne revient pas alimenter les règles, la stratégie de pièces de rechange, les plans de maintenance préventive ou la responsabilité des fournisseurs. Le système n’apprend jamais.
Si vous voulez une traduction « board-level » : vous n’avez pas acheté de l’uptime, vous avez acheté de l’observability. L’uptime se fabrique dans l’exécution.
Transformer la télémétrie en operating system : la règle de la boucle fermée
J’incite les équipes à concevoir la fiabilité comme une boucle de contrôle d’usine. Le signal d’un capteur n’est que la mesure. Le reste, c’est votre contrôleur, votre actionneur et votre feedback.
Voici la règle de boucle fermée que j’utilise :
Aucune alerte n’est « réelle » tant qu’elle n’a pas un owner, une règle de décision et un résultat vérifié.
En pratique, cela se traduit par un petit nombre d’exigences non négociables.
1) Attribuez l’ownership par classe d’actifs, pas par technologie
Ne créez pas une équipe « connected services » propriétaire de dashboards. Désignez des owners d’actifs responsables de l’uptime pour une classe d’équipements (pompes, compresseurs, boucles HVAC, convoyeurs, onduleurs). Leur rôle : rendre le système plus silencieux et plus juste dans le temps.
Quand j’ai dirigé des organisations de R&D couvrant l’embedded, le cloud, l’électronique, la mécanique et le QA, j’ai retenu une chose : cross-functional ne veut pas dire sans owner. Cela veut dire un owner clairement accountable, capable de mobiliser les fonctions quand il le faut.
2) Définissez des règles de décision en argent et en temps
Chaque alerte doit avoir une politique de réponse explicite sur le plan économique. Pas « haut, moyen, bas ». Des seuils réels :
- Quel est le coût d’un faux positif (déplacement, interruption de production, pièce remplacée inutilement) ?
- Quel est le coût d’un raté (rebuts, production perdue, risque sécurité, pénalités contractuelles) ?
- Quelle est la dernière fenêtre d’intervention sûre (heures, équipes, jours) ?
C’est à ce moment-là que l’uptime devient une conversation business, plutôt qu’un débat d’ingénierie.
3) Traitez la réponse comme un produit, pas comme un projet
Les meilleurs programmes considèrent « diagnostiquer, décider, déclencher, vérifier » comme un produit avec une roadmap. Vous itérez sur les playbooks de réponse comme vous itérez sur du software.
Dans l’industrie, le playbook compte souvent plus que le prédicteur. Une règle simple, exécutée vite, bat un modèle brillant avec des validations lentes et des pièces manquantes.
4) Fermez la boucle avec trois tables de feedback
Si vous voulez que le système progresse, il faut un apprentissage structuré. J’utilise trois tables, même dans des dispositifs légers :
- Correspondance alerte → ordre de travail : chaque alerte crée du travail, ou bien elle est rejetée avec un code motif.
- Résultat de l’ordre de travail : défaut confirmé, panne évitée, aucun problème constaté, mauvais actif, mauvais seuil.
- Post-mortems des « escapes » : toute panne sur un actif monitoré est revue au prisme de « qu’a-t-on vu, quand, et pourquoi n’a-t-on pas agi ? »
C’est de la discipline qualité appliquée à la fiabilité. J’ai passé onze ans dans l’électronique de puissance et sur des rôles de qualité marché ; la leçon se transfère parfaitement : sans feedback structuré, vous répétez les mêmes défaillances avec de meilleurs graphiques.
Un exemple vécu : les devices connectés sont faciles, les interventions sont difficiles
Quand j’étais CEO d’une business unit de contrôles connectés pour bâtiments, les clients demandaient souvent « plus de données » pour réduire les appels au service. Nos devices pouvaient les fournir. Le point dur, c’était l’intégration opérationnelle côté client.
Ceux qui réussissaient faisaient quelques choses peu glamour :
- Ils nommaient un owner opérations pour les systèmes critiques (pas un owner IT pour la plateforme).
- Ils standardisaient les principaux modes de défaillance et stockaient les pièces qui tombent réellement en panne.
- Ils construisaient un chemin court entre alerte et accès (autorisations, clés, règles de site), pour que le technicien puisse agir dans la fenêtre d’intervention.
Ceux qui échouaient faisaient l’inverse. Ils déployaient des capteurs à grande échelle, routaient les alertes vers des boîtes mail génériques, et débattaient de la précision des prédictions pendant que les mêmes actifs continuaient à lâcher. Ils n’avaient pas de boucle fermée. Ils avaient un data lake rempli d’opinions.
C’est aussi pour cela que je suis exigeant sur l’architecture dans mes propres ventures. Chez IBHQ et Shopeno, je traite les signaux opérationnels comme des engagements : chaque métrique existe pour déclencher une décision, une tâche ou un résultat côté client. Sinon, c’est du bruit — et on le supprime. L’objectif n’est pas la visibilité. L’objectif, c’est une exécution maîtrisée.
Checklist board et opérateurs pour ce trimestre
Si vous siégez dans un board ou si vous opérez, et que vous voulez savoir si votre programme capteurs va réellement faire bouger l’uptime, posez ces questions, dans cet ordre :
- Quel résultat business visez-vous ? Moins de pannes, un MTTR plus court, moins de dépenses de pièces, un OEE plus élevé, moins d’interventions d’urgence ? Choisissez un indicateur principal.
- Qui possède l’uptime par classe d’actifs ? Des noms, pas des départements. Si l’ownership est partagé, il n’appartient à personne.
- Quels sont les 10 principaux modes de défaillance ? Si vous ne pouvez pas les lister, vous ne faites pas de reliability : vous faites de l’instrumentation.
- Quelle est la politique de décision par mode de défaillance ? Seuil, fenêtre d’intervention, arbitrage économique.
- Comment une alerte devient-elle du travail ? Montrez le chemin du signal à l’ordre de travail, puis au dispatch, puis à la vérification. Mesurez les délais.
- Quel est le learning loop ? Où consignez-vous les résultats, comment les revoyez-vous, et comment les utilisez-vous pour ajuster les seuils, les plans de maintenance préventive et les pièces ?
- Que supprimez-vous ? Quelles alertes, quels dashboards, quelles métriques effacez-vous activement pour réduire le bruit ?
Si vous voulez une lecture plus structurée de ma manière de penser les systèmes « operator-grade », mon cadrage dans « AI Architecture Isn’t a Diagram. It’s an Operator’s Checklist. » s’applique ici aussi : la valeur est dans les contrats, l’ownership et le traitement des échecs, pas dans les schémas.
Mon avis : arrêtez de financer des capteurs, financez la capacité de réponse
La plupart des organisations sous-investissent dans le « dernier kilomètre » de la fiabilité. Elles financent les devices, la connectivité, les plateformes et les pilotes. Puis elles affament le système de réponse : pièces, accès, capacité de dispatch, playbooks et temps dédié aux post-mortems.
Si vous voulez de l’uptime, budgétez d’abord les sujets ingrats. Achetez la discipline. Ensuite seulement, ajoutez de la télémétrie là où elle resserre la boucle.
C’est la différence entre une usine connectée et une usine contrôlée. L’une collecte des signaux. L’autre transforme ces signaux en moins de pannes.
Newsletter
Des notes de terrain, directement dans votre boîte.
Des notes occasionnelles et sans bruit, prises de l'intérieur du travail : ce qui a été livré, ce qui a cassé, et ce que je ferais différemment.