26 October 2026 · 8 min de lecture
Le playbook du builder pour transformer le vibe code en logiciel livrable
L’IA (intelligence artificielle) a rendu la génération de code facile. Elle n’a pas rendu la mise en production sûre. L’écart se comble avec des gates, des périmètres de responsabilité et un modèle de coût du changement que vous pouvez faire respecter.
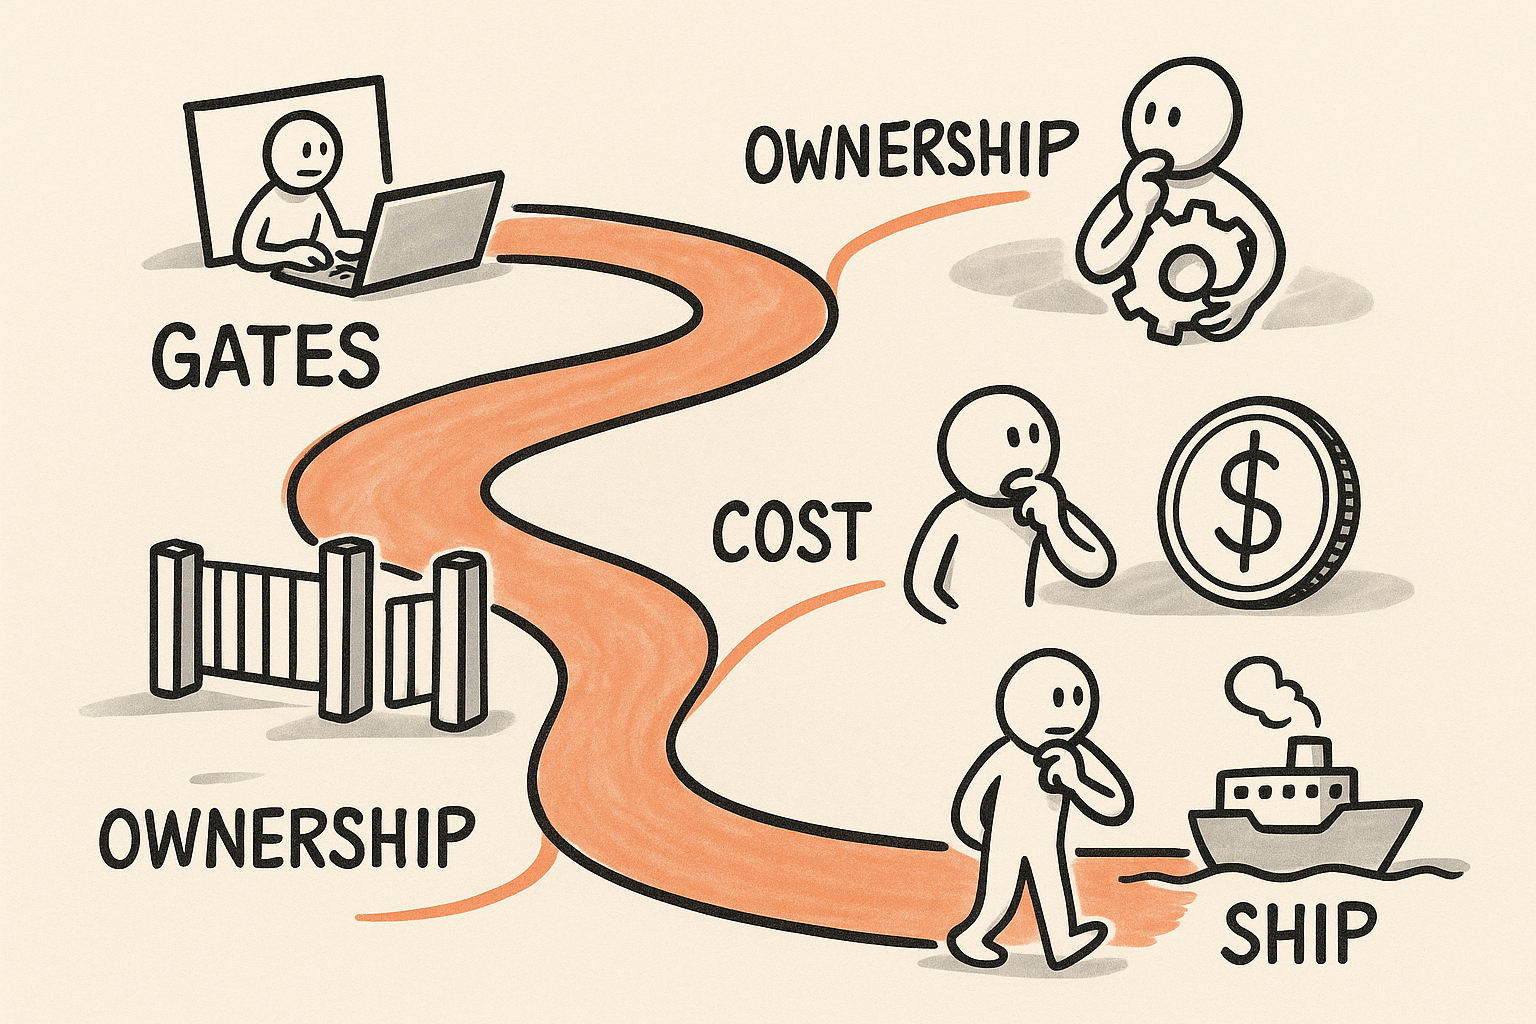
On voit apparaître un nouveau type de confiance dans les équipes. Quelqu’un décrit un produit en français courant, obtient une démo qui fonctionne en quelques heures, et conclut que c’est « fini » . On a l’impression que la livraison est désormais un problème réglé.
Puis le premier vrai utilisateur arrive. L’auth fuit. Des secrets traînent dans un repo. Le modèle de données ne migre pas. Les logs ne servent à rien. Personne n’est capable d’expliquer d’où vient la moitié du code. La démo était rapide, mais la livraison reste lente — simplement de manière plus chaotique.
L’erreur, c’est de croire que le sujet est la « génération de code » . Ce n’est pas le cas. Le sujet, c’est de transformer une sortie générée en un produit capable de survivre au contact des clients, des auditeurs et de votre propre astreinte. La réponse n’est pas « plus de prompts » . La réponse, c’est un état d’esprit de software factory, où « factory » signifie des gates répétables et une responsabilité claire — pas de la bureaucratie.
C’est pour cela que l’idée de voir revenir les software factories est intéressante, en particulier le fait de soumettre une application vibe-coded à un service qui la valide, la teste et la « produit » de façon répétable, comme décrit dans Why software factories are back, and how they work in the age of AI. Que vous achetiez une plateforme ou construisiez votre version interne, le schéma est le même : vous ne faites pas confiance à la sortie, vous faites confiance au process.
1) Traitez le vibe code comme une entrée non fiable
Le code généré n’est pas « mauvais » . Il porte simplement un risque non valorisé. Il arrive sans la traçabilité habituelle des décisions de conception, des arbitrages et des revues qui rendent un système maintenable.
Commencez donc par une règle simple et assumée :
- Tout ce que produit une IA est non fiable tant que cela n’a pas passé les gates. Comme vous traiteriez du trafic entrant, des fichiers uploadés ou des packages tiers.
- « Ça marche sur ma machine » n’est pas un état. Le seul état qui compte est : « passe le pipeline ».
Ce cadrage apporte deux bénéfices. D’abord, il enlève la charge émotionnelle : personne n’a à « défendre » le code. Ensuite, il rend la suite évidente : définir les gates, puis les automatiser jusqu’à ce qu’elles deviennent ennuyeuses.
2) Construisez des gates applicables, pas des guidelines
La plupart des équipes ont déjà des « standards » . Le problème, c’est qu’ils sont écrits comme un document et appliqués comme une suggestion. Le vibe coding amplifie cette faiblesse parce qu’il inonde le système de changements.
Ce qu’il vous faut, c’est un ensemble de gates appliquées mécaniquement. Une modification passe, ou elle ne passe pas.
Le socle minimal de gates
- Tests : des unit tests pour la logique, des integration tests pour les frontières, et au moins un test end-to-end sur le parcours utilisateur principal. L’objectif n’est pas la couverture comme trophée. L’objectif, c’est de détecter vite quand un refactor casse un comportement.
- Sécurité : analyse statique, scan des dépendances, détection de secrets. Exigez aussi un threat model pour toute fonctionnalité qui touche à l’identité, au paiement ou aux données sensibles. Gardez-le léger, mais rendez-le obligatoire.
- Provenance : un build qui permet de répondre : quel commit a produit cet artifact, quelles dépendances il embarque, et qui l’a approuvé. Si vous ne pouvez pas répondre à ces questions en quelques minutes, vous n’avez pas de release process : vous avez un rituel.
- Observability : logs structurés, quelques métriques clés, et une gestion des erreurs raisonnable. Si vous ne voyez pas l’échec, vous déboguerez en devinant — et la charge d’incidents montera.
Le point le plus important : les gates doivent s’exécuter par défaut. Une case à cocher manuelle crée des exceptions, et les exceptions finissent par devenir le vrai système.
J’ai développé ce sujet sous un autre angle dans Default-On Agentic Coding Is a Release Pipeline Change, Not a Feature Toggle. Le principe est identique ici : vous modifiez la mécanique de release, vous n’ajoutez pas un gadget.
3) Tracez des périmètres de responsabilité qui tiennent malgré la vitesse
L’IA augmente le throughput. C’est précisément pour cela que la responsabilité floue devient dangereuse. Quand le volume de changements explose, des frontières mal définies se transforment en : « tout le monde y a touché, personne n’en est responsable ».
Un modèle qui fonctionne consiste à séparer ce qui peut être généré de ce qui doit être possédé.
Définissez trois zones
- Zone sandbox : prototypes, outils internes, spikes jetables. Le vibe coding est bienvenu. Le coût de l’erreur est faible. L’accès est limité. Les données sont synthétiques.
- Zone produit : code orienté client. Les changements exigent l’ensemble complet de gates. C’est ici que vous investissez dans les tests, la discipline de migration et l’observability.
- Zone de contrôle : identité, facturation, permissions, données cœur, et tout ce qui peut créer une responsabilité légale ou financière. Ce code évolue lentement, avec une revue explicite et des plans de rollback.
Ce zonage ne vous ralentit pas. Il évite un échec classique : le chemin le plus rapide devient l’unique chemin, et vos raccourcis de prototype se retrouvent derrière l’auth de production.
Une règle interne aide beaucoup : seul un owner nommé peut faire passer du code de la sandbox au produit, puis du produit à la zone de contrôle. Pas un comité. Une personne, responsable des conséquences.
4) Rendez le « coût du changement » visible, puis intégrez-le dans chaque décision
Le vibe coding donne une impression de vitesse parce que la première version ne coûte pas cher. Le piège, c’est que les deuxième et troisième versions deviennent souvent plus coûteuses : personne n’a investi dans l’ossature qui rend le changement sûr.
Vous avez besoin d’un modèle de coût du changement, suffisamment simple pour guider des décisions hebdomadaires.
Un modèle pragmatique de coût du changement
- Coût de construction : le temps pour implémenter la fonctionnalité.
- Coût d’évolution : le temps pour la modifier en sécurité le mois prochain. Il dépend surtout de la qualité des tests, de la clarté des interfaces et de la conception des migrations de données.
- Coût de défaillance : le temps passé à déboguer, à gérer les incidents, à faire du support client, les dommages de réputation, et le rework sous pression.
L’effet cumulatif vient de là : l’IA réduit le coût de construction, mais elle peut augmenter le coût d’évolution et le coût de défaillance si vous n’investissez pas dans les gates et les frontières de responsabilité. Si vous ne célébrez que le coût de construction, vous optimisez sans le vouloir la fragilité.
Une manière simple de rendre ce modèle opérationnel : ajoutez une question à l’accord produit/ingénierie : « Quel est le plan de rollback et le plan de tests ? » Si la réponse est floue, vous ne regardez pas un changement livrable. Vous regardez une démo.
C’est aussi là que la formalisation paie. Pas des specs lourdes, mais juste assez de précision pour éviter qu’un comportement ambigu ne devienne une ambiguïté en production. J’ai résumé cette posture dans Formal Specs Are Incident Tools, Not Academic Proofs.
5) Faites de la factory un service, puis laissez les équipes accélérer
Le levier le plus puissant consiste à traiter le release pipeline comme un produit. Cela signifie : des utilisateurs (vos ingénieurs), des exigences de disponibilité (la fiabilité des builds) et une roadmap (quelles gates automatiser ensuite).
Quand c’est bien fait, un schéma apparaît :
- Les équipes génèrent plus de code.
- Le pipeline rejette tôt les mauvais changements.
- Les corrections se font pendant que le contexte est encore frais.
- La production devient plus calme, même quand le throughput augmente.
Concrètement, on obtient une « factory » capable d’ingérer un repo, d’exécuter des validations, de produire des artifacts et de pousser des sorties déployables — ce qui reflète l’idée d’un service qui valide et « produit en série » des applications vibe-coded de manière répétable, comme expliqué dans l’article ZDNET.
Un point d’attention : ne confondez pas automatisation et déresponsabilisation. Votre pipeline peut exécuter des contrôles, mais il ne peut pas décider quel niveau de risque est acceptable pour votre activité. Cela reste votre responsabilité.
Une leçon vécue : de la vitesse sans gates, c’est juste du travail différé
J’ai vu une équipe reconstruire deux fois la même intégration, à quelques semaines d’intervalle : la première version « marchait », mais sans tests utiles et sans contrat à la frontière. Chaque changement devenait une loterie de régressions. Ce n’était pas un problème de talent. C’était un problème de discipline. Dès qu’on a ajouté une vraie gate d’integration tests et attribué l’ownership de l’interface à une seule personne, le churn s’est arrêté.
Le point central est là : l’IA vous aidera volontiers à produire la première version de n’importe quoi. Votre avantage, c’est d’être le type de builder capable de produire la dixième version sans couler.
Conclusion : la vitesse de l’IA est réelle, mais elle ne se cumule qu’à l’intérieur de contraintes
Les meilleures équipes ne gagneront pas en générant plus de code. Elles gagneront en rendant le changement bon marché. Cela impose des gates applicables, des périmètres de responsabilité nets, et un modèle visible de coût du changement qui affiche le vrai prix des raccourcis.
Si vous ne deviez faire qu’une chose ce trimestre : choisissez une surface produit, déclarez le socle minimal de gates non négociable, et faites du pipeline l’unique chemin vers la production. Vous aurez l’impression d’être plus lent pendant une semaine. Puis vous constaterez que vous livrez plus vite, parce que vous ne payez plus d’intérêts sur un travail fragile.
Newsletter
Des notes de terrain, directement dans votre boîte.
Des notes occasionnelles et sans bruit, prises de l'intérieur du travail : ce qui a été livré, ce qui a cassé, et ce que je ferais différemment.