26 October 2026 · 8 min de lecture
Le playbook de l’opérateur pour rendre le stockage réseau « bankable »
Traiter l’interconnexion comme le chemin critique, souscrire les revenus comme un prêteur, et piloter l’O&M comme une usine.
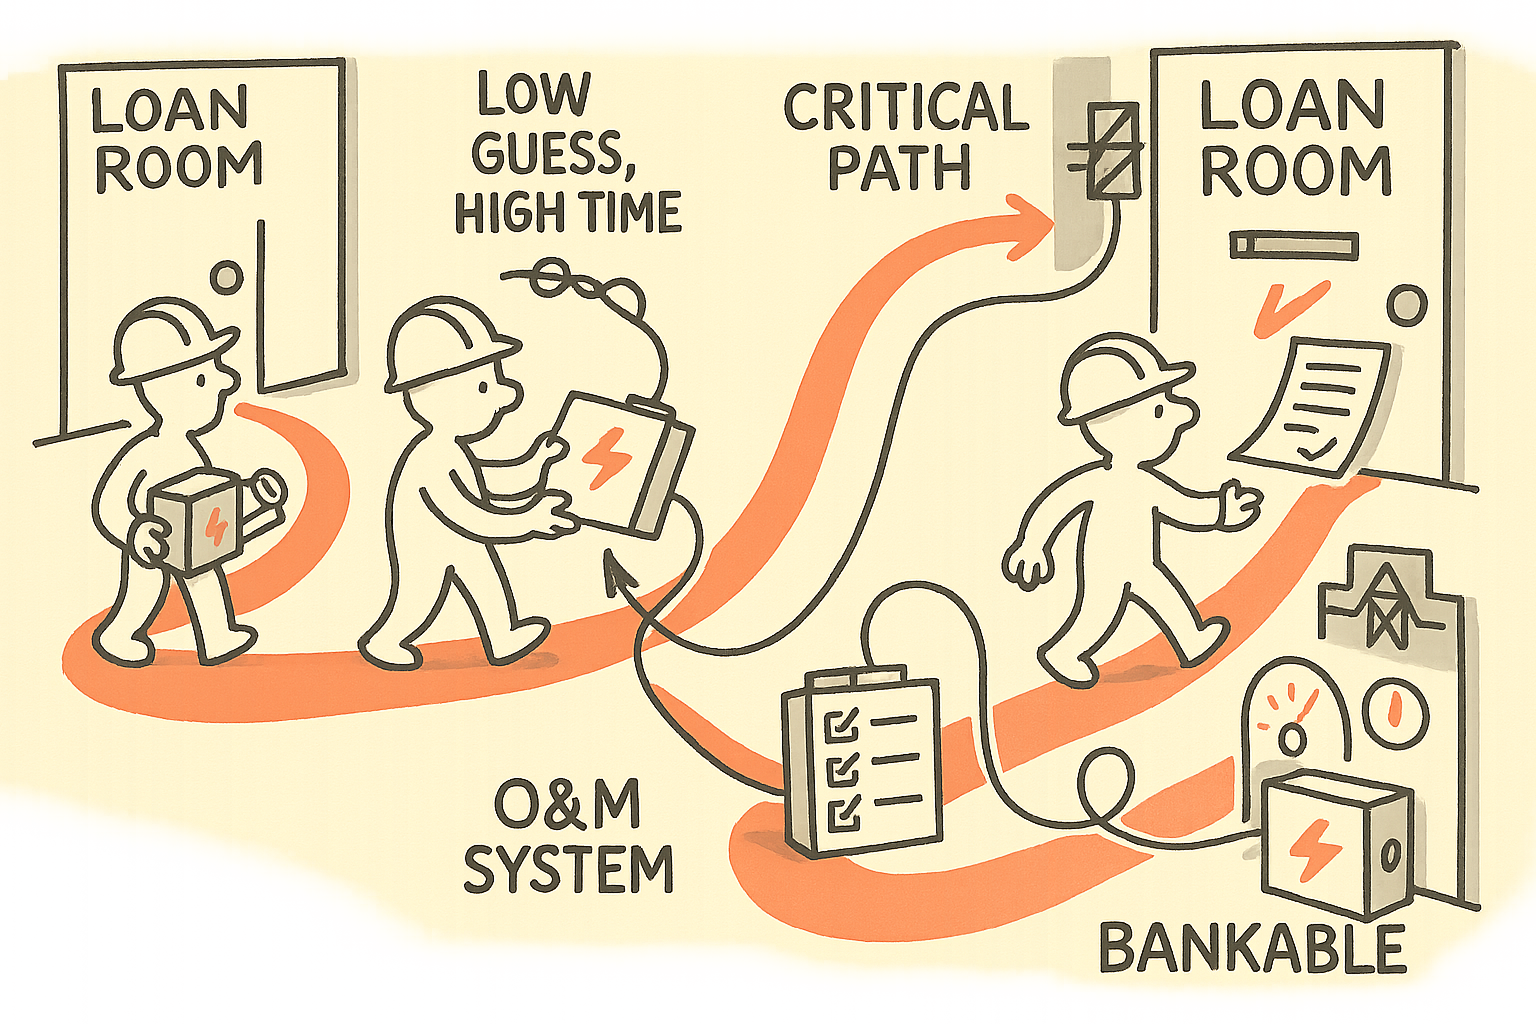
Je suis très positif sur le stockage à l’échelle réseau. En revanche, je suis allergique à la « bankability » au format PowerPoint.
Dans le stockage d’énergie, « bankable » n’est pas une ambiance. C’est une chaîne de décisions qui réduit les inconnues jusqu’au point où un prêteur, un assureur et un board peuvent signer sans retenir leur souffle. Quand j’observe les projets qui passent en comité et ceux qui s’enlisent, le schéma est constant : les gagnants n’ont pas, par magie, une meilleure technologie. Ils exécutent mieux sur des contraintes… en apparence peu glamour.
Aujourd’hui, le stockage bénéficie d’une vraie dynamique côté procurement. Par exemple, des utilities du Massachusetts ont signé des contrats totalisant 4,5 GWh de stockage. Ce n’est pas un projet de laboratoire. C’est un signal : acheteurs et régulateurs avancent, et le marché privilégie les opérateurs capables de fermer le risque.
Voici mon playbook d’opérateur pour rendre le stockage à l’échelle réseau « bankable ». Pas « finançable en théorie ». Bankable dans la vraie vie, celle qui déborde.
1) Mettre l’interconnexion sur le chemin critique — ou admettre que vous spéculez
La plupart des équipes disent que l’interconnexion est « importante ». Peu la traitent comme la contrainte qui fixe toute la cadence du projet.
C’est à l’interconnexion que se cachent les risques planning, que le capex gonfle sans bruit, et que la date de début des revenus recule trimestre après trimestre. Et dès que la COD bouge, tout le reste suit : disponibilité des EPC, prix des équipements, staffing, conditions d’assurance, jusqu’à la crédibilité de votre PMO.
En tant qu’opérateur, je pilote l’interconnexion comme un goulot d’étranglement industriel :
Un responsable unique, clairement redevable. Pas un steering committee. Une personne qui se lève le matin avec cette responsabilité.
Une cartographie des dépendances, en langage simple. Quelles décisions dépendent de quelles études, quelles dates sont réelles, et lesquelles relèvent de l’espoir.
Une réduction hebdomadaire du risque. Les risques ne sont pas « suivis ». On les réduit. Chaque semaine, quelque chose doit passer de inconnu → connu, ou de élevé → moyen.
Une discipline « design-to-interconnect ». Si les exigences d’interconnexion imposent des limites d’export, des besoins en puissance réactive ou des schémas de protection, alors la conception de la centrale s’aligne. Pas l’inverse.
Ce n’est pas de l’administratif. C’est votre horloge de revenus. Si votre calendrier d’interconnexion reste flou, votre modèle est une fiction.
2) Souscrire les revenus de façon conservatrice — et distinguer « modèle » et « contrat »
Dans le stockage, beaucoup adorent empiler les sources de revenus. Ça transforme le tableur en fusée.
Un opérateur doit faire l’inverse. Construire un scénario de base que vous pouvez défendre dans une salle hostile.
Ma règle : votre bankability se joue sur le pire mois que vous pouvez encaisser, pas sur le meilleur mois que vous pouvez vendre.
Concrètement, cela veut dire :
Donner la priorité aux revenus contractés ou clairement définis. Si c’est merchant, traitez-le comme volatil. Si cela dépend d’un nouveau design de marché, traitez-le comme incertain.
Prendre des hypothèses prudentes sur la disponibilité et la dégradation. Si vous ne l’avez pas démontré dans votre contexte d’exploitation, n’empruntez pas dessus.
Modéliser la curtailment et la congestion comme des réalités. Si le nœud peut devenir compliqué, il le deviendra.
Stress-tester des pannes « banales ». Mise en service en retard, lot défectueux, problème sur une classe d’onduleurs, rollback de firmware du BMS, délais d’approvisionnement des pièces. Ce sont ces incidents qui dégradent le DSCR sans faire de bruit.
J’ai créé et dirigé des activités SaaS et fintech (IBHQ, Shopeno, etc.). Dans ces univers, on peut parfois « itérer » pour rattraper un écart de prévision. Sur le réseau, l’itération coûte cher. Souscrivez comme un prêteur, même si vous êtes equity. Cela force une meilleure ingénierie et des contrats plus solides.
3) Concevoir la disponibilité comme un produit industriel, pas comme un projet
La disponibilité, c’est là que l’économie du stockage se fait ou se défait. Et elle ne vient pas de slogans. Elle vient d’un système d’exploitation qui rend les pannes visibles, reproductibles et corrigeables.
Quand je pilotais la qualité et la performance marché en électronique de puissance dans un groupe industriel mondial, la leçon était simple : les problèmes terrain sont rarement « aléatoires ». Ce sont des motifs que vous n’avez pas su capter assez tôt. Plus tard, en prenant en charge la QA et les tests sur hardware et software chez un fabricant de systèmes de contrôle pour le bâtiment, j’ai vu à quel point on évite des douleurs si l’on traite la couverture de test, la traçabilité et la discipline de release comme non négociables.
Pour le stockage à l’échelle réseau, j’aime décomposer l’ingénierie de la disponibilité en trois couches :
A) Concevoir pour la maintenabilité
La modularité plutôt que les coups d’éclat. Pouvez-vous isoler un container, une string ou un onduleur sans arrêter tout le site ?
Faire du temps d’accès et de remplacement un critère de conception. S’il faut huit heures pour atteindre un composant en sécurité, vous venez d’intégrer du downtime dans l’installation.
Une stratégie de spares alignée sur les lead times. La meilleure pièce de rechange, c’est celle que vous avez déjà au moment où la panne survient.
B) Installer une discipline de release et de change-control
Le firmware et le software font partie du risque de l’actif. Les mises à jour BMS/EMS/onduleur exigent un déploiement progressif, des plans de rollback et une responsabilité claire.
Configuration management. Savoir ce qui est installé, et où. En permanence. En exploitation, « on pense que » n’est pas acceptable.
C) Piloter l’O&M comme une usine
Une cadence de management quotidienne. Des standups courts. Des blocages explicites. Des voies d’escalade rapides.
Un « top loss tree ». Les cinq premières causes de downtime, mises à jour chaque semaine, avec responsables et contre-mesures.
Le temps moyen de détection et de remise en service. Pas seulement le temps moyen entre pannes. Détecter et rétablir sont des compétences opérationnelles.
Si vous voulez un parallèle avec l’IA (intelligence artificielle) : l’architecture n’est pas un schéma. C’est une checklist que les opérateurs peuvent exécuter. Même logique dans le stockage. La « centrale », c’est du hardware, du software, des personnes et des processus. Si ce cadrage vous intéresse, mon article AI Architecture Isn’t a Diagram. It’s an Operator’s Checklist. applique la même logique d’opérateur dans un autre domaine.
4) Rendre le risque lisible : aligner contrats, garanties et exploitation
Les boards et les prêteurs n’ont pas peur du risque. Ils ont peur d’un risque non valorisé et d’une responsabilité floue.
Quand je dirigeais, comme CEO, une business unit smart-building multi-pays, le défi récurrent tenait à l’alignement : promesses commerciales, réalité produit et capacité opérationnelle doivent être cohérentes. Sinon, vous subissez une érosion de marge et des escalades qui consomment la bande passante du leadership.
Dans le stockage à l’échelle réseau, la bankability progresse si vous faites tôt trois alignements :
Contracter en fonction de votre réalité d’exploitation. Si vous ne pouvez pas tenir un certain temps de réponse, ne le promettez pas. Si vous avez besoin d’un accès à distance pour diagnostiquer, inscrivez-le dans les accords.
Des garanties cohérentes avec le duty cycle. Ne laissez pas le modèle commercial supposer un profil d’usage que la garantie exclut. Cet écart devient un litige futur.
Une responsabilité claire aux interfaces. Répartition EPC vs OEM vs opérateur. Qui possède quoi quand la performance baisse ? L’ambiguïté crée du downtime.
Un outil très concret : une « failure ownership matrix » d’une page, qui couvre les 20 principaux modes de défaillance (déclenchements d’onduleur, perte de communications, panne HVAC, alarmes de déséquilibre cellule, dérive capteur, etc.). Pour chacun : méthode de détection, premier intervenant, escalade, spare nécessaire et responsable contractuel. Cette page fait plus pour la bankability que la plupart des decks.
5) La grille de lecture du board : trois questions pour distinguer les bâtisseurs des présentateurs
Quand je suis avec un propriétaire, un board ou un comité d’investissement, je pose trois questions. Elles sont simples. Elles sont inconfortables. Elles fonctionnent.
Quel est l’unique point de chemin critique ce trimestre ? Si la réponse est « plusieurs », vous n’avez pas la main. Je parie que le vrai sujet, c’est l’interconnexion ou le permitting.
Quelle hypothèse, si elle est fausse, détruit l’économie du projet ? S’ils ne savent pas la nommer, ils n’ont pas stress-testé avec honnêteté.
Montrez-moi le système d’exploitation de la disponibilité. Pas l’organigramme. La cadence, les métriques, l’escalade, les spares et le change control.
La bankability ne se gagne pas au financial close. Elle se mérite chaque semaine après la COD.
Conclusion : mon point de vue
Le stockage à l’échelle réseau continuera d’attirer du capital. Mais le capital se concentrera sur les équipes qui traitent l’interconnexion comme une contrainte, les revenus comme quelque chose à défendre et l’O&M comme une discipline industrielle.
Si vous voulez une boussole, retenez ceci : rendez le projet lisible. Des plannings lisibles. Des risques lisibles. Des responsabilités lisibles. Une exploitation lisible. C’est ce que les boards peuvent gouverner, et ce que les prêteurs peuvent souscrire.
Le reste n’est que commentaire.
Newsletter
Des notes de terrain, directement dans votre boîte.
Des notes occasionnelles et sans bruit, prises de l'intérieur du travail : ce qui a été livré, ce qui a cassé, et ce que je ferais différemment.