26 October 2026 · 8 min de lecture
L’IA dans l’industrie ne bloque pas sur les modèles. Elle bloque sur le contrat de données.
Si vous voulez dépasser le pilote et passer à l’échelle, traitez la donnée comme une exigence de production : CTQ définis, exceptions prises en charge, traçabilité imposée et financement lié aux KPI de l’usine.
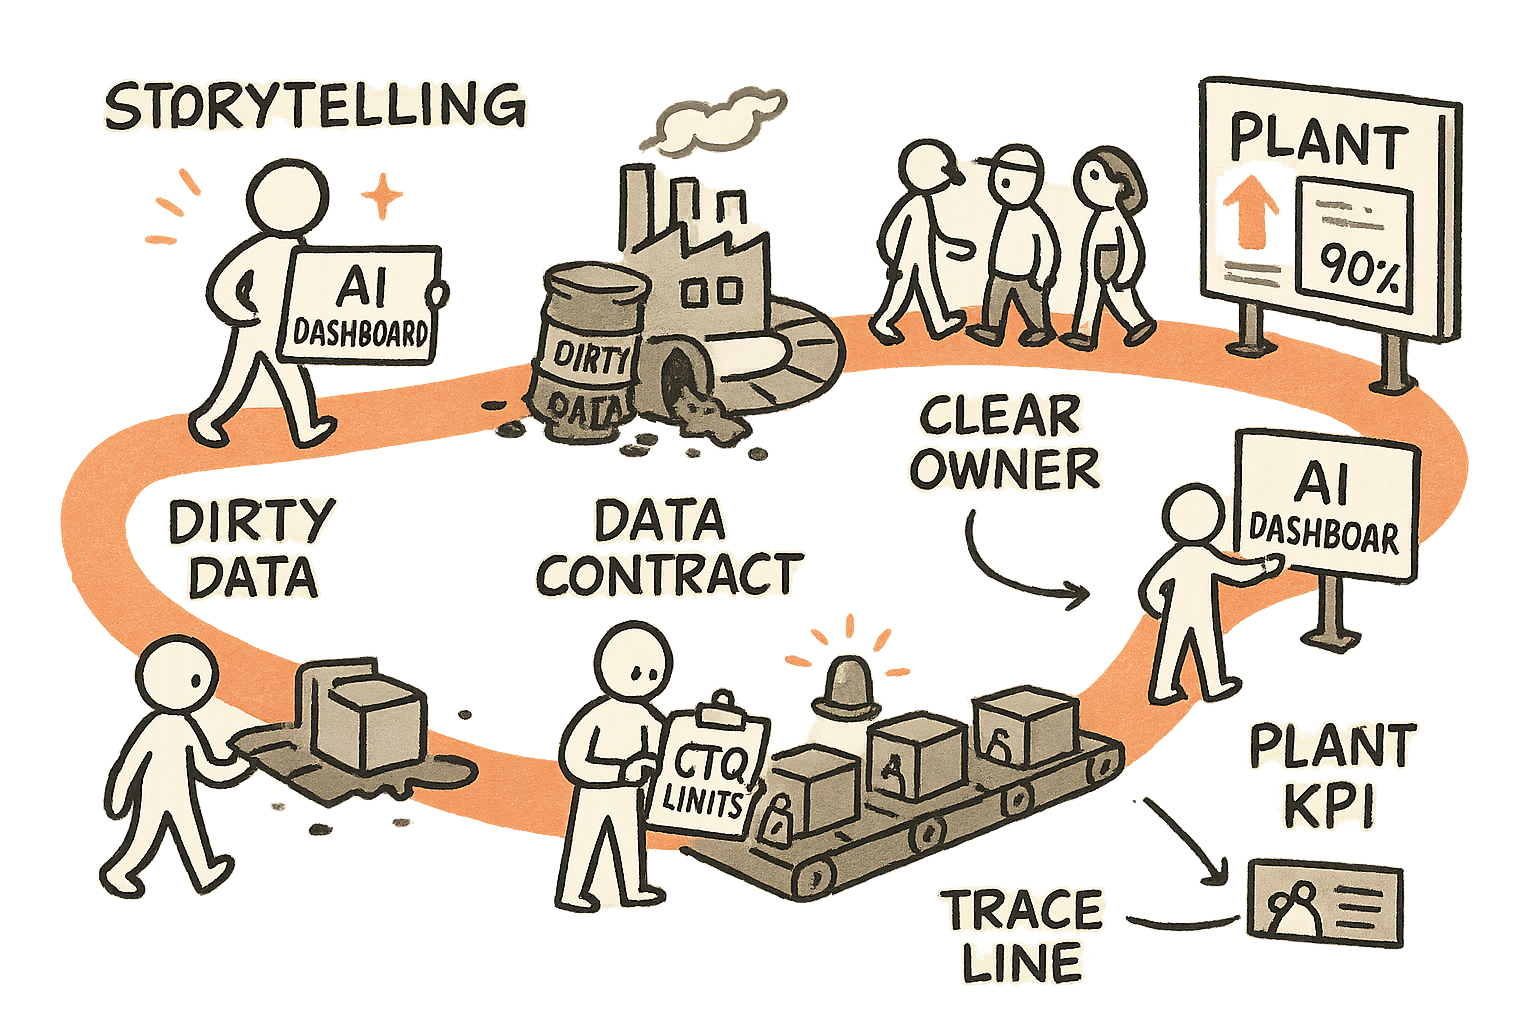
J’ai vu le même scénario se répéter dans des usines, des organisations produit et des salles de conseil. Une équipe livre un pilote d’IA prometteur. Le premier dashboard impressionne. Le premier modèle bat la baseline. Puis l’usine cesse d’y croire. La maintenance l’ignore. La qualité le conteste. Les opérations concluent que la donnée est « sale ». Et le programme s’enlise, discrètement.
Ma position est simple et directe : l’IA industrielle échoue rarement à cause des algorithmes. Elle échoue parce que personne n’a rédigé, financé et fait respecter le contrat de données.
Pendant onze ans dans l’électronique de puissance, entre leadership qualité, gestion de projets, ingénierie d’application et R&D, j’ai constaté que les meilleurs sites avaient un point commun : ils traitaient les exigences produit et process comme des contrats, avec des responsables, des tolérances et des voies d’escalade. Plus tard, quand j’ai piloté les opérations au Danemark et en Ukraine dans l’électrification et le stockage d’énergie, la même règle s’appliquait. Une exigence qui n’a pas de responsable, qui n’est pas mesurée et revue, se dégrade. La donnée n’y échappe pas.
Un contrat de données n’est pas un document. C’est un accord d’exploitation entre l’usine et chaque système qui touche à la vérité. Il définit ce que signifie « bon », qui en est responsable, comment on traite les exceptions, et comment on détecte la dérive avant que cela ne se transforme en crise.
Le vrai goulot d’étranglement n’est pas la « qualité des données ». C’est la propriété de la donnée.
Dans la plupart des usines, la donnée est traitée comme un sous-produit. On la collecte parce qu’on le peut. Puis l’IA arrive et demande à l’usine de prendre des décisions sur la base de ce sous-produit. C’est un sujet de gouvernance, pas un sujet de modélisation.
En industrie, nous savons déjà faire vivre des contrats. Nous le faisons avec les CTQ (critical to quality), les plans de contrôle, les calendriers d’étalonnage, les MSA et les flux de non-conformités. L’erreur consiste à voir la donnée comme un actif IT. Pour l’IA, la donnée est un intrant de production. Elle doit être gérée avec la même rigueur que le rendement, la casse et la disponibilité.
Voici le cadrage qui fonctionne auprès des opérateurs comme des boards : votre système d’IA n’est fiable qu’à hauteur du maillon le plus étroit de sa chaîne de mesure. Si un capteur est mal étalonné, si un tag PLC est réaffecté sans versioning, si une équipe modifie un code manuel sans formation, le modèle n’est pas « faux ». Le contrat de données a été violé.
Ce que doit contenir un contrat de données
- Des CTQ pour la donnée, pas seulement pour le produit : définir les quelques variables qui pilotent la décision, et préciser les exigences de complétude, de délai, de précision et d’unités.
- Des responsables nommés : un responsable opérationnel par CTQ, et un responsable technique par pipeline. « Tout le monde » n’est pas un responsable.
- Une traçabilité que vous pouvez expliquer au tableau : d’où vient le signal, comment il est transformé, et où il est consommé.
- Une gestion des exceptions standardisée : que fait-on lorsqu’une valeur est manquante, hors plage, dupliquée, en retard ou surchargée manuellement.
- Un contrôle des changements : comment les changements de tags, de recettes et les upgrades d’équipements se répercutent sur les features et les seuils.
Si vous ne pouvez pas répondre à ces points en 10 minutes, ne passez pas à l’échelle. Réparez d’abord le contrat.
Passer à l’échelle est un sujet de déploiement usine, pas un sujet de déploiement data science
La plupart des programmes d’IA sont financés comme de l’innovation et gouvernés comme de l’IT. L’industrie ne fonctionne pas ainsi. Une usine exécute ce qui est relié à ses KPI, revu dans sa cadence, et porté par des personnes qui ont l’autorité de changer le process.
Quand j’étais CEO d’une business unit smart building et domotique, nous avons déployé des capteurs et des contrôles connectés dans plusieurs pays. La technologie n’a jamais été le plus difficile. Le plus difficile, c’était de définir ce que signifiait l’« intégrité du signal » entre marchés, installateurs, versions firmware et releases cloud. Si vous ne standardisez pas les exceptions, vous n’avez pas un produit. Vous avez des démos.
En usine, les « exceptions » ne sont pas des cas limites. C’est le quotidien. Un capteur tombe en panne. Une ligne s’arrête. Un lot est scindé. Une boucle de retouche démarre. Si votre IA suppose une donnée propre et continue, elle n’est pas conçue pour l’industrie. Le contrat de données doit encoder la réalité de l’usine, pas celle du laboratoire.
La séquence de déploiement « operator-first »
- Choisissez une décision, pas un modèle. Exemples : « bloquer ou libérer un lot », « planifier la maintenance cette semaine ou la suivante », « réduire un pic d’énergie sans casser le takt ».
- Définissez la vérité minimale viable : les CTQ nécessaires pour prendre cette décision en sécurité.
- Instrumentez les exceptions : valeurs manquantes, overrides manuels, défauts capteurs, arrivées tardives. Rendez les exceptions visibles et comptez-les.
- Liez le financement au KPI : réduction de scrap, first-pass yield, OEE, arrêts non planifiés, énergie par unité. Si l’usine ne le ressent pas, elle ne le tiendra pas dans la durée.
- Déployez avec un « kill switch » : l’usine doit pouvoir revenir au standard précédent, sans drame.
C’est pour cela que j’aime raisonner en checklists. J’ai décrit cet état d’esprit dans l’architecture IA comme la checklist d’un opérateur. L’architecture n’est pas un schéma. C’est une suite d’engagements qui résistent au contact du réel.
CTQ de données : traiter la mesure comme une exigence produit
En qualité, on ne débat pas de façon abstraite pour savoir si une mesure est « suffisante ». On fixe des tolérances, on valide la méthode, et on audite la dérive. Faites la même chose pour les inputs de l’IA.
Un template pragmatique pour des CTQ de données
- Définition : nom, unité, fréquence d’échantillonnage et système source de référence (PLC, MES, SCADA, ERP, LIMS).
- Plage acceptable et contraintes physiques : quelles valeurs sont impossibles ou dangereuses.
- Fenêtre de fraîcheur : à partir de quand « en retard » invalide la décision.
- Seuil de complétude : quel pourcentage de valeurs manquantes est toléré avant de couper la sortie du modèle.
- Règle de réconciliation : que fait-on lorsque le MES et l’ERP divergent, ou lorsqu’une saisie manuelle contredit une lecture automatisée.
- Cadence d’audit : qui revoit cela chaque semaine, et ce qui déclenche une action corrective.
Si vous le faites correctement, l’usine fera confiance au système parce qu’il se comporte comme un process maîtrisé. Sinon, chaque anomalie devient un débat. Or les débats ne passent pas à l’échelle.
Une gouvernance qui fonctionne : rendre visibles les exceptions, la traçabilité et les incitations
Je n’aime pas le théâtre de la gouvernance. Des comités qui discutent de principes pendant que les opérateurs gèrent l’urgence ne changent pas les résultats. Une gouvernance efficace est un système d’exploitation : elle transforme les sujets de données en tickets, responsables, délais et prévention.
Voici la question de pilotage que j’ai utilisée dans mes rôles de direction : « Quand le modèle se trompe, qui est réveillé ? » Si la réponse n’est pas claire, le système n’est pas gouvernable.
Le minimum de gouvernance pour l’IA en industrie
- Un scoreboard de métriques unique : adoption de l’IA liée aux KPI de l’usine, plus la santé du contrat de données (taux d’exceptions, dépassements de fraîcheur, événements de dérive de schéma).
- Une traçabilité audit-able : pas d’abord pour la conformité, mais pour dépanner à 2 h du matin.
- Un standard de travail pour les overrides : quand les opérateurs overrident l’IA, ils doivent choisir un reason code. Non pour les contrôler, mais pour apprendre de manière systématique.
- Une discipline de release : les changements de features et les mises à jour de modèles suivent le même niveau de sérieux que les changements firmware dans l’embarqué.
- Un budget cohérent avec la responsabilité : si les opérations portent le KPI, elles doivent co-porter le budget capteurs, intégration et maintenance des pipelines.
C’est aussi là que l’IA appliquée devient concrète. Dans mes ventures comme Shopeno et IBHQ, je pense à l’IA comme un comportement produit, pas comme une expérience scientifique. Le produit doit se dégrader proprement, s’expliquer, et laisser une piste d’audit. Les usines ont besoin des mêmes propriétés, avec des enjeux plus élevés et des boucles de retour plus rapides.
La lecture board : financer le contrat de données comme vous financez la fiabilité
Si vous siégez à un board ou si vous portez un P&L, voici le piège à éviter. Vous financez une initiative IA comme un projet, puis vous attendez une valeur qui s’accumule. Mais le contrat de données sous-jacent est un système vivant. Il nécessite de la maintenance, comme la maintenance préventive des équipements.
Mon point de vue : traitez le contrat de données comme un sujet de fiabilité. Il doit avoir un backlog, une cadence, et une histoire de ROI claire, reliée aux KPI de l’usine. Sans financement, cela devient « le problème de tout le monde » et le job de personne.
Si vous voulez un diagnostic simple pour ce trimestre, demandez trois chiffres à la prochaine revue ops :
- Taux d’exceptions : à quelle fréquence le pipeline IA voit des inputs manquants, en retard ou invalides.
- Mean time to innocence : en combien de temps l’équipe peut prouver si le problème vient du capteur, de l’intégration, de la transformation ou du modèle.
- Boucle d’apprentissage des overrides : pourcentage d’overrides qui débouchent sur une mise à jour du contrat, une mise à jour de formation ou un changement de process.
Si ces chiffres sont inconnus, le modèle n’est pas le goulot d’étranglement. Le contrat l’est.
Ma conclusion tient en une ligne. Arrêtez de demander : « Le modèle est-il précis ? » Commencez à demander : « Le contrat de données est-il applicable ? » L’IA industrielle passe à l’échelle quand la donnée est traitée comme une vérité opérationnelle, avec des CTQ, des responsables, de la traçabilité et des exceptions standardisées. Tout le reste n’est qu’un pilote.
Newsletter
Des notes de terrain, directement dans votre boîte.
Des notes occasionnelles et sans bruit, prises de l'intérieur du travail : ce qui a été livré, ce qui a cassé, et ce que je ferais différemment.