27 octobre 2026 · 9 min de lecture
Financeriez-vous un data center offshore avec du satellite et des batteries ?
Beau rendu, actif réel. Le sujet n’est pas la production, mais la maintenabilité, les garanties et un contrat qui tient même après de mauvaises semaines en mer.
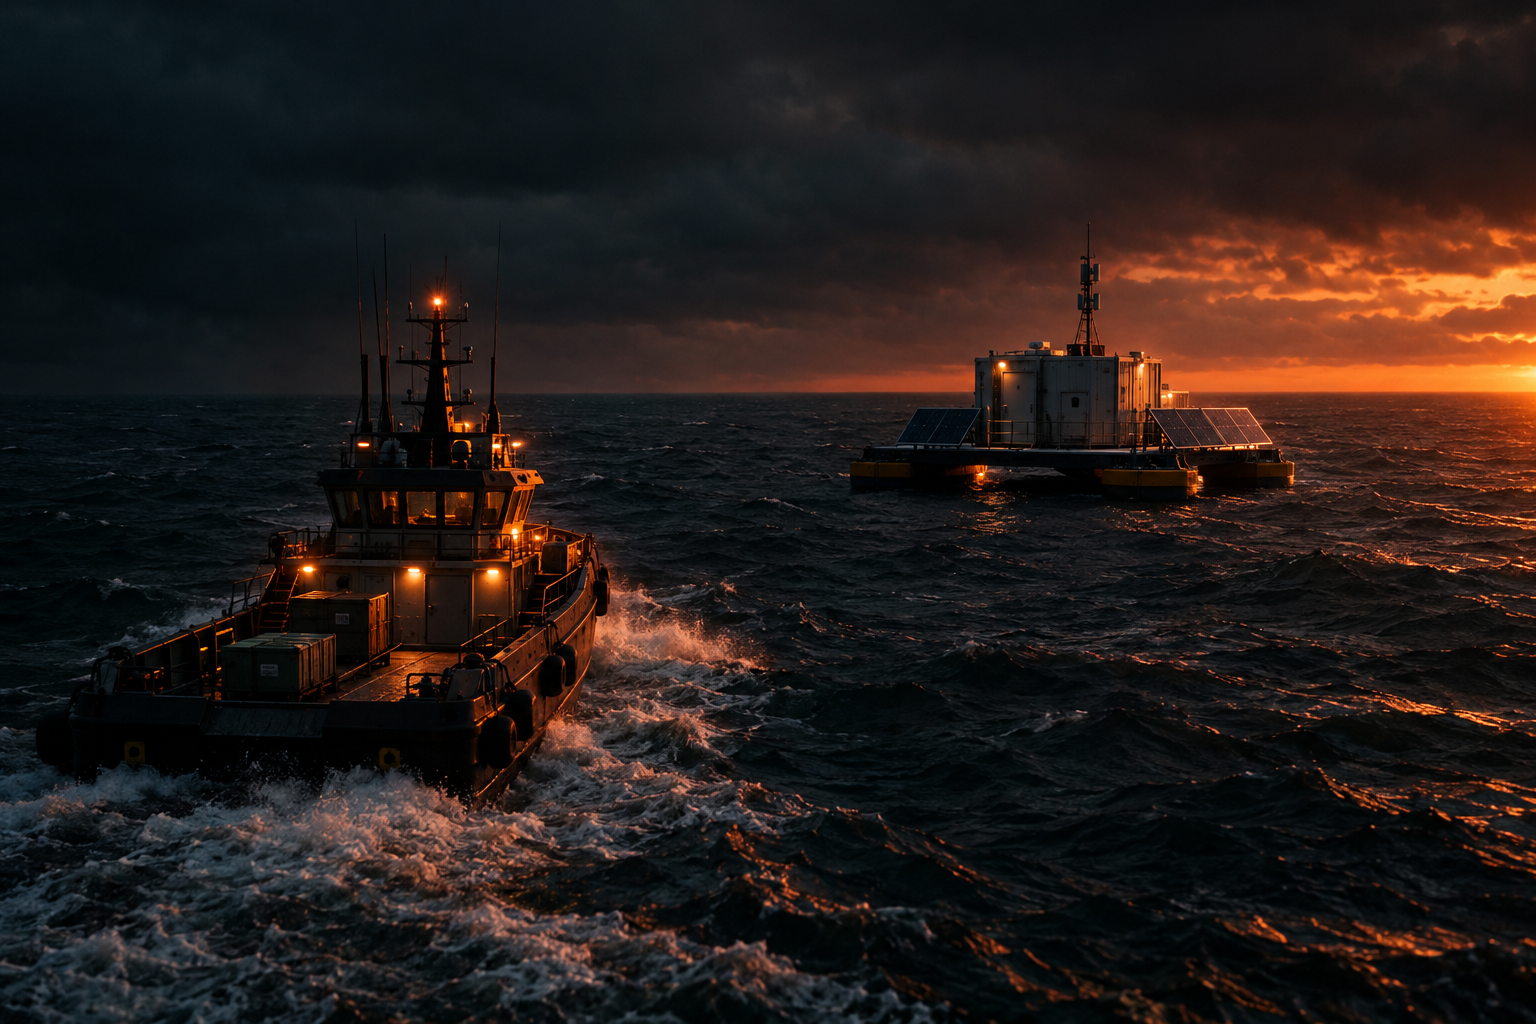
J’aime les systèmes énergétiques ambitieux. Et je sais aussi ce qui se passe quand un concept séduisant rencontre le sel, le mouvement et des fenêtres d’intervention qui se font annuler à répétition.
C’est pour cela que la plupart des concepts « data center offshore + renouvelables flottantes + batteries » ressemblent à des rendus. Ils parlent en kilowatts et en modules, puis deviennent vagues là où l’on juge réellement une infrastructure : disponibilité, maintenabilité, pièces de rechange, conditions de garantie et, surtout, qui paie quand le réel s’invite.
Le point de départ de ce texte est une note récente sur le plan de Mocean Energy visant des déploiements commerciaux à partir de 2030, qui combine des data centers offshore modulaires avec un système électrique offshore intégrant du solaire flottant et des batteries. Le concept s’appuie aussi sur des communications par satellites en orbite basse et vise 500 kW à 1 MW par unité sans raccordement au réseau. Ils mentionnent 18 mois d’essais offshore à l’échelle réelle. Très bien. Tester, c’est le minimum.
La vraie question est : qu’est-ce qui lâche en premier, et comment rédiger des garanties pour qu’un prêteur traite cela comme une infrastructure plutôt que comme un prototype doté d’un service marketing ?
Les premières pannes sont banales : accès, sel et variabilité
Si vous déployez du compute en mer, votre ennemi n’est pas un événement unique et spectaculaire. C’est l’accumulation de petites dégradations et de corrections qui arrivent trop tard.
Dans les faits, les premières difficultés se concentrent généralement sur six points.
- La logistique d’O&M, plus que l’ingénierie. Vous manquerez des maintenances planifiées. La météo vous clouera au port. Vous aurez un technicien en astreinte alors que l’unité est inaccessible. Le coût n’est pas le taux journalier. Le coût, c’est l’arriéré qui se crée derrière chaque tâche repoussée.
- Corrosion, connectique et mains humaines. L’air salin attaque là où vous ne le voulez pas : terminaisons, loquets, presse-étoupes, liaisons de mise à la terre. Le matériel peut être « marine grade » sur le papier. Le point faible, c’est l’interface entre deux pièces, et tout ce qu’on ouvre et referme quarante fois par an.
- Qualité de puissance et cyclage. Les batteries rendent l’off-grid possible. Elles imposent aussi un régime qui fatigue les composants. Onduleurs, éléments de bus DC, contacteurs et ventilateurs de refroidissement ne vieillissent pas au calendrier : ils vieillissent à l’effort et à la commutation.
- Dérive du thermique. Les hypothèses de refroidissement des data centers viennent de plateformes stables. Offshore, c’est plus de vibrations, plus d’encrassement, et des filtres qui se colmatent plus tôt que ce que prévoyait votre tableur. La sanction n’est pas l’inconfort : c’est le throttling et une capacité de revenus perdue.
- Fragilité des communications et illusion du « remote hands ». S’appuyer sur des communications LEO n’a rien d’absurde. Faire comme si cela remplaçait des diagnostics locaux et des modes sûrs, si. Si la liaison devient instable pendant un événement électrique, le système doit se protéger seul, sans attendre qu’un paquet arrive.
- Pièces de rechange et frontières de garantie. La particularité offshore est simple : chaque pièce non prépositionnée se transforme en indisponibilité que vous ne pouvez pas planifier. Chaque garantie qui exclut « environnement corrosif », « maintenance inadéquate » ou « cyclage anormal » se transforme en problème de financement.
Rien de tout cela n’est spectaculaire. C’est précisément pour cela que les projets échouent. On tombe amoureux de l’architecture et on sous-investit dans la réalité du service.
La fiabilité est une cible de conception, pas une promesse de service
Voici la distinction qui compte pour la finançabilité.
Une promesse de service dit : « nous réparerons vite ». Offshore, c’est un mensonge coûteux.
Une cible de fiabilité dit : « cela continue à fonctionner tant que vous ne pouvez pas y toucher ». Et là, tout change : choix des composants, philosophie de redondance, instrumentation, et façon de dégrader proprement.
Si je structurai une unité de compute offshore, j’imposerais trois principes de conception.
- Tolérance à la première panne là où l’accès est difficile. Si une pièce se trouve derrière une trappe qui nécessite un bateau et une mer calme, n’en faites pas un point unique de défaillance. Dupliquez-la, surdimensionnez-la ou déplacez-la.
- La remplaçabilité prime sur l’optimisation. Le modulaire n’a de sens que si l’on peut vraiment échanger un module. Pas avec un technicien de labo et un tournevis dynamométrique, mais avec une équipe terrain, des gants, des embruns et la pression du temps.
- Modes de dégradation définis. Quand l’énergie devient rare, est-ce que vous délestez, réduisez le compute, ou réduisez la marge de refroidissement ? Choisissez. Automatisez. Rendez-le réversible. Ne laissez pas le système découvrir tout seul son mode de panne.
Je l’ai appris à mes dépens il y a des années, en support d’applications de variateurs de vitesse dans des environnements difficiles : la spécification phare ne casse presque jamais en premier. C’est l’interface. C’est l’hypothèse de maintenance. Le « ça ira » autour des connecteurs devient une cause racine qui se répète.
Pièces, diagnostics et « mean time to shore »
Si vous voulez que l’on traite cela comme une infrastructure, il vous faut une doctrine explicite sur les pièces et la réparation.
À terre, l’hypothèse implicite est : « quelqu’un peut apporter la pièce demain ». Offshore, le métrique équivalent est le « mean time to shore ». Combien de temps entre la détection d’un défaut et le retour de l’unité à un régime stable ?
Pour réduire ce délai, je structurerais le système autour de quatre pratiques.
- Pièces en deux niveaux. Niveau 1 sur l’actif : les pièces qui tombent le plus souvent en panne et qu’une petite équipe peut remplacer en sécurité (ventilateurs, filtres, packs capteurs, modules de communications, alimentations). Niveau 2 à terre : des ensembles plus lourds qui demandent une préparation (module onduleur, segments de racks batteries, sections de skid de refroidissement). Si une pièce de niveau 1 n’est pas physiquement à bord, ce n’est pas une pièce de niveau 1.
- Un triage à distance qui se termine par une décision. Votre télémétrie doit permettre de trancher : continuer, dégrader (derate) ou s’arrêter. Pas d’offrir un dashboard. De prendre une décision. C’est là que beaucoup de produits « connectés » déçoivent quand l’incident est réel.
- Une maîtrise de configuration assumée. Si le logiciel et le firmware dérivent au sein d’une flotte, votre dépannage devient de l’archéologie. Ce n’est pas tenable quand les communications sont limitées et les visites coûteuses. (C’est aussi pour cela que j’adhère à la position défendue dans Formal Specs Are Incident Tools, Not Academic Proofs : un incident ne pardonne pas l’ambiguïté.)
- Les consommables comme ligne contractuelle. Filtres, anodes sacrificielles, dessicants, kits de joints. Mettez-les dans le plan, chiffrez-les, et reliez-les à des objectifs de disponibilité. Sinon, ils deviennent des événements « on a oublié ».
Des garanties qui résistent au réel (et cessent d’être de la fiction)
La plupart des garanties sont rédigées pour protéger le fournisseur. Le project finance a besoin de l’inverse : des résultats prévisibles quand quelque chose casse.
Si vous vendez une capacité de compute offshore, vous vendez en réalité un paquet de risques : intermittence énergétique, perte de communications, sel, vibrations, erreurs humaines, défauts composants. Vous ne pouvez pas balayer cela. Vous devez l’allouer.
Voici comment je pousserais la structuration des garanties et de la couverture de performance pour qu’elles deviennent finançables.
1) Séparer « disponibilité énergétique » et « disponibilité compute »
Une unité off-grid sera parfois contrainte par l’énergie. Ce n’est pas une panne, c’est de la physique. Il faut l’encadrer explicitement.
- Garantie de disponibilité énergétique : un indicateur lié à la production du système électrique offshore et au comportement du stockage, pas à la disponibilité IT. C’est là que vous ancrez la performance du solaire flottant et des batteries.
- Garantie de disponibilité compute : un indicateur lié au service de compute effectivement délivré, lorsque l’énergie est suffisante. Cela maintient la promesse commerciale au bon niveau de vérité.
Sans cette séparation, chaque discussion tourne au jeu de la faute. « Les serveurs étaient à l’arrêt. » « Non, les batteries étaient vides. » La finance déteste le blâme. Elle veut des formules.
2) Payer des liquidated damages en crédits de service, tout en plafonnant la queue de risque
Des pénalités 100 % cash peuvent tuer un jeune propriétaire d’actifs. Des crédits « best effort » ne valent rien pour un acheteur. Le bon compromis : des crédits de service, avec un plafond clair et une escalade.
- Définissez un objectif mensuel de disponibilité.
- En dessous de l’objectif, les crédits s’appliquent automatiquement.
- En dessous d’un second seuil, vous déclenchez un plan de remédiation et, potentiellement, des step-in rights.
- Au-delà d’un plafond défini, l’acheteur peut résilier et le prêteur obtient une issue maîtrisée.
Il ne s’agit pas d’être généreux. Il s’agit d’éviter une agonie lente où chacun espère que le mois prochain sera meilleur.
3) Intégrer corrosion et cyclage dans le duty profile de référence, puis garantir sur cette base
La corrosion offshore n’est pas un « abus ». Le cyclage des batteries n’est pas « anormal ». Si votre garantie exclut l’environnement central, ce n’est pas une garantie.
Rendez le duty profile explicite au contrat : classe de salinité, enveloppe vibratoire, hypothèses de profondeur de cyclage, tolérance aux coupures de communications. Puis garantissez contre cette réalité déclarée.
4) Définir des KPI de maintenabilité, pas seulement de disponibilité
Pour des actifs offshore, les indicateurs avancés comptent plus que les indicateurs retardés. J’inclurais :
- Taux de rétablissement à distance : part des incidents résolus sans visite.
- Âge de la maintenance différée : arriéré maximal autorisé pour des tâches données.
- Mean time to shore : délai entre défaut et retour à une production stable.
C’est la différence entre un système qui se dégrade en silence et un système que l’on maintient en bonne santé.
Le test de financement : pouvez-vous expliquer un mauvais mois sans raconter une histoire ?
On financera presque n’importe quoi si le contrat transforme le chaos en chiffres.
Voici donc mon test simple entre « beau rendu » et « infrastructure » : lorsque vous traversez un mauvais mois, le propriétaire de l’actif, l’acheteur et le prêteur peuvent-ils s’accorder sur ce qui s’est passé en utilisant le même jeu de données et les mêmes formules ?
Si la réponse dépend d’une interprétation, vous passerez votre vie en réunion. Si la réponse tient dans un tableur que n’importe qui peut auditer, vous pouvez construire un portefeuille.
Voilà ma position sur les data centers offshore alimentés par des renouvelables flottantes. Le concept technique est plausible. Le concept commercial échouera si la maintenabilité, les duty profiles et les calculs de garanties ne sont pas conçus avec autant de soin que la plateforme.
Si vous en construisez un, ne demandez pas « est-ce que ça peut marcher ? ». Demandez plutôt : « combien cela coûtera-t-il pour que ça continue à fonctionner quand nous ne pourrons pas y accéder ? ». Puis inscrivez cette réponse dans le deal. Le reste, c’est du marketing.
Newsletter
Des notes de terrain, directement dans votre boîte.
Des notes occasionnelles et sans bruit, prises de l'intérieur du travail : ce qui a été livré, ce qui a cassé, et ce que je ferais différemment.