26 October 2026 · 9 min de lecture
L’architecture IA n’est pas un schéma. C’est la checklist d’un opérateur.
Si vous voulez passer à l’échelle, arrêtez de « construire une stack » et commencez à piloter un système de production : contrats, evals, SLO, contrôles humains et gestion d’incident.
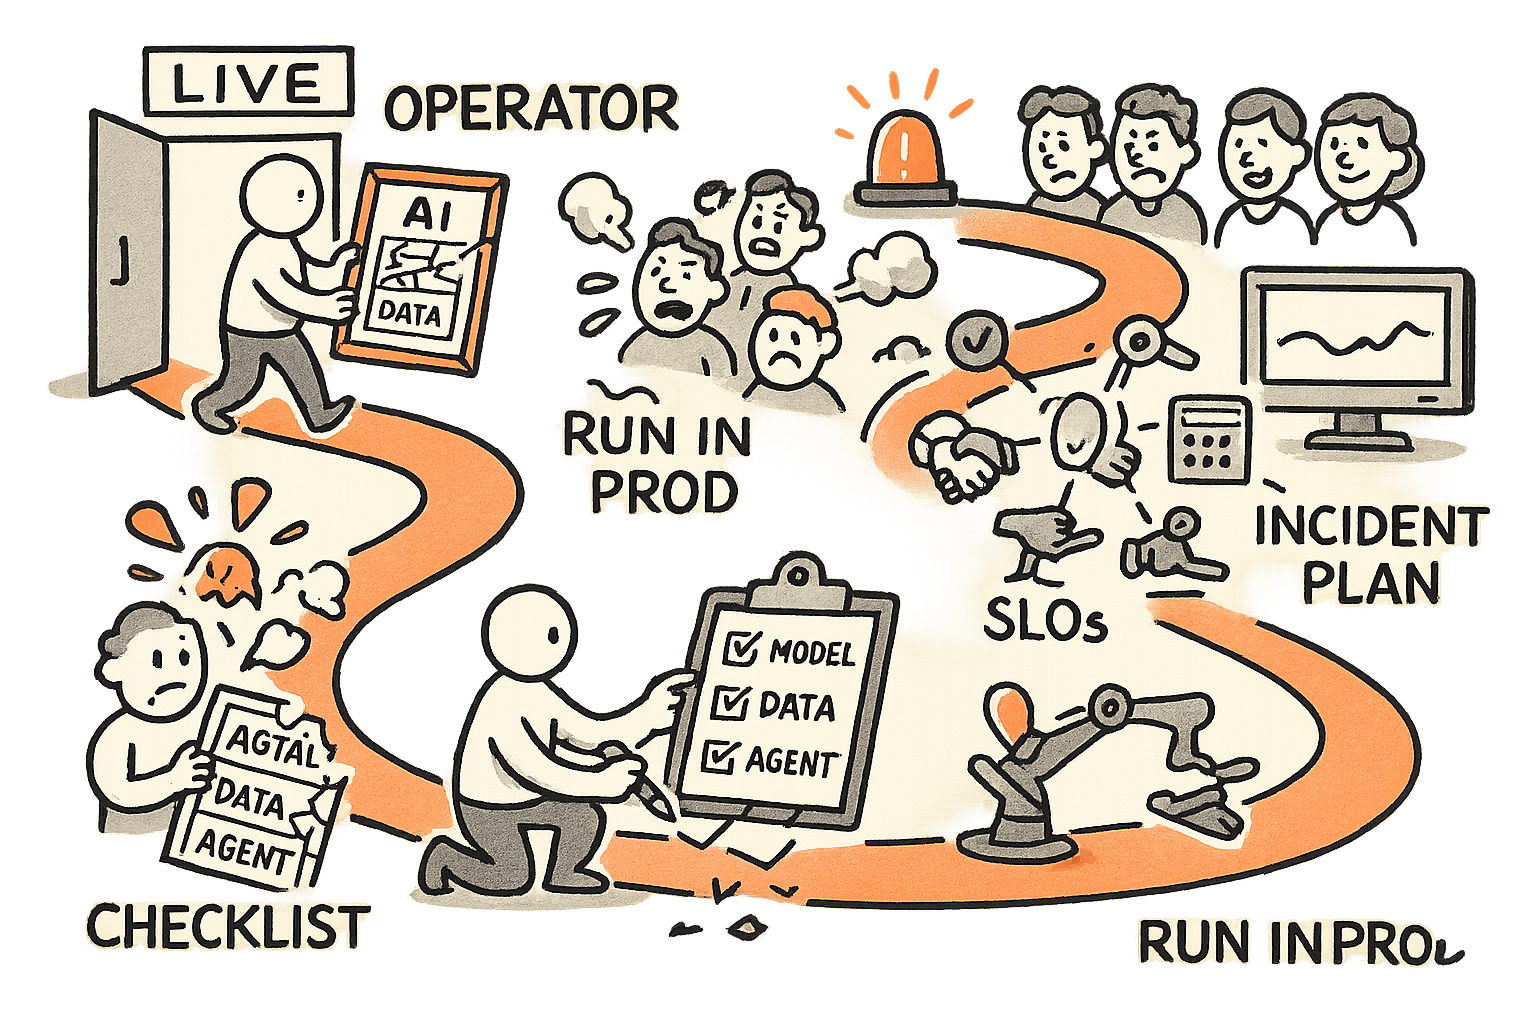
J’ai vécu ce sujet des deux côtés : celui qui livre la technologie, et celui qui assume les conséquences opérationnelles.
Quand je dirigeais les opérations dans une activité d’électrification et de stockage d’énergie, je ne pouvais pas me réfugier derrière des roadmaps. L’ingénierie, la R&D, la production, la supply chain et le service rencontraient le réel tous les jours. Un produit qui « fonctionne à peu près » n’est pas un produit ; c’est un passif. Plus tard, à la tête d’une business unit smart building dans plusieurs pays, les équipements connectés et les services cloud m’ont rappelé la même leçon sous une autre forme : l’uptime n’est pas une fonctionnalité. C’est une discipline d’exploitation.
Avec l’IA (intelligence artificielle), on rejoue le même film — en plus rapide. Les dirigeants demandent « l’architecture IA ». On leur répond par un schéma : modèles, vector databases, agents, orchestration. C’est propre. Et ensuite, ça casse là où ça compte : en production, chez les clients, sous contrainte de temps.
Mon point de vue est simple : l’architecture IA n’est pas un schéma. C’est la checklist d’un opérateur. Si vous ne pouvez pas l’exploiter, vous ne l’avez pas.
Le cadrage le plus pertinent que j’ai vu récemment figure dans la synthèse de MIT Technology Review sur les fondamentaux dont les dirigeants ont besoin pour passer l’IA à l’échelle. Elle confirme ce que les opérateurs savent déjà : plus l’IA devient capable et agentic, plus votre surface de risque s’élargit. La réponse n’est pas davantage d’enthousiasme. C’est davantage de discipline.
La tension : l’IA veut être un produit, mais se comporte comme de l’exploitation
Dans l’industrie, on ne confond pas un prototype et une ligne de production. On met des gates. On qualifie. On écrit des procédures. On mesure le rendement. On mène des actions correctives. L’IA mérite le même traitement, parce que ses modes de défaillance ressemblent moins à des « bugs » qu’à une dérive de process.
Et la dérive est mortelle. Pas parce que le modèle est « mauvais », mais parce que le système autour n’est pas défini. Les entrées changent. Les outils changent. Les usages changent. La réglementation change. Et soudain votre assistant IA donne une réponse fausse avec aplomb, ou votre agent déclenche la mauvaise action, et tout le monde découvre — trop tard — que personne n’est responsable du système d’exploitation qui l’entoure.
Si vous êtes membre de board ou opérateur, voici le changement de perspective que je veux que vous adoptiez : traitez l’IA comme un système d’exploitation de production. Pas comme une démo. Pas comme une « capability ». Pas comme une slide. Un système d’exploitation avec des contrats, des gates de qualité, des engagements de performance et un playbook d’incident.
La checklist de l’opérateur : ce que signifie vraiment « architecture IA »
Je choisis volontairement d’éviter une liste de composants. Les composants s’achètent. L’intégrité opérationnelle, non. Voici la checklist que j’utilise quand j’évalue un programme IA — qu’il serve un workflow de manufacturing, un assistant de support field-service, un back office fintech, ou une couche IA dans l’une de mes propres ventures comme Shopeno ou IBHQ.
1) Des data contracts, pas un simple « accès aux données »
Dans l’électronique de puissance, plus tôt dans ma carrière, les problèmes qualité étaient rarement mystérieux. On pouvait les retracer : empilement de tolérances, changement de fournisseur, trou dans les tests. L’IA a besoin de la même discipline de traçabilité, à commencer par la frontière des entrées.
- Définissez des schémas d’entrée pour chaque source pertinente (tickets, flux capteurs, factures, SOP, historiques de chat). Versionnez-les.
- Désignez un data owner qui peut approuver les changements et en assumer les conséquences.
- Fixez des attentes de fraîcheur et de complétude comme vous le feriez pour un KPI de production.
- Documentez les transformations autorisées (anonymisation, synthèse, déduplication) afin de pouvoir reproduire les sorties.
« On a branché le modèle sur notre data lake » n’est pas un contrat. C’est un incident à venir.
2) Les evals, c’est votre contrôle d’entrée
En hardware et en systèmes embarqués, on qualifie les composants avant de monter en cadence. L’IA ne fait pas exception, sauf qu’ici le « composant » change de comportement selon les prompts, les context windows, le retrieval et les outils disponibles.
- Maintenez un jeu d’évaluation vivant qui reflète le travail réel (pas du théâtre de benchmark).
- Mesurez la réussite de bout en bout, pas seulement l’accuracy : temps de résolution, taux d’escalade, volume de rework généré, impact client.
- Testez les modes de défaillance : hallucinations en situation d’incertitude, violations de policy, mauvais usage d’outils, fuite de données.
- Exécutez les evals à chaque changement : modèle, prompt, retrieval, schéma d’outil, logique de routage.
Si vous ne pouvez pas décrire votre dispositif d’évaluation avec autant de précision qu’un poste de test en usine, vous n’êtes pas prêt à passer à l’échelle.
3) Des SLO, pas « ça a l’air OK »
Quand je dirigeais des organisations de R&D en software embarqué et cloud, nous avons appris à traduire la douleur client en engagements mesurables. L’IA doit suivre la même logique.
- SLO de latence : time-to-first-token et time-to-action.
- SLO de fiabilité : taux de réussite des tool-calls, taux de réussite du retrieval, comportement de fallback.
- SLO de qualité : taux de réussite sur les cas critiques des evals ; seuils « no-regret » pour les sorties réglementées.
- SLO de coût : coût par cas résolu ou par workflow terminé, pas coût par token.
Un board comprend les SLO. Les opérateurs savent piloter des SLO. Les équipes ne pilotent pas une impression.
4) Les contrôles humains ne sont pas une faiblesse ; c’est le plan de contrôle
Les programmes IA oscillent souvent entre deux extrêmes : le fantasme du « full automation » et le « human-in-the-loop » utilisé comme couverture sécurité, sans définition claire.
Les opérateurs raisonnent autrement. On définit des modes de contrôle.
- Mode advisory : l’IA recommande ; l’humain décide. Adapté aux domaines à haut risque et aux premiers déploiements.
- Exécution sous garde-fous : l’IA agit dans des limites strictes (plafonds, templates, étapes d’approbation).
- Autopilot : l’IA exécute de bout en bout, avec des conditions d’arrêt mesurables et une auditabilité réelle.
La question n’est pas « human-in-the-loop ou pas ». La question est : où se situe l’autorité, où se situe la responsabilité, et quel est le mécanisme d’override ?
5) Gestion d’incident : partez du principe qu’à l’échelle vous vous tromperez
Dans les systèmes de pilotage de bâtiments connectés, chaque incident a deux coûts : l’impact immédiat chez le client et l’érosion de confiance sur le long terme. L’IA en ajoute un troisième : le risque épistémique. Les équipes ne savent plus ce qui est fiable.
- Définissez les types d’incidents : mauvaise réponse, mauvaise action, breach de policy, fuite de données, coût hors de contrôle, performance dégradée.
- Mettez en place un kill switch : désactiver l’exécution d’outils, couper les appels externes, revenir à un modèle sûr, ou basculer vers un flux 100 % humain.
- Logguez pour l’investigation : prompts, contexte, résultats de retrieval, appels d’outils, sorties, actions utilisateur (avec contrôles de confidentialité).
- Menez des postmortems qui modifient le système : mise à jour des evals, des contracts, du routage, des droits.
Sans capacité de réponse aux incidents, passer l’IA à l’échelle revient à élargir le rayon d’explosion.
Un constat vécu : pourquoi l’IA rime avec exécution industrielle
Voici le pattern que j’ai observé à répétition — d’abord dans la tech industrielle, puis en SaaS et en fintech, et aujourd’hui dans l’IA appliquée :
La contrainte est rarement la capacité. La contrainte, c’est la coordination sous incertitude.
Quand je dirigeais une activité smart building dans plusieurs pays, nous avions des équipements embarqués sur le terrain, des services cloud qui évoluaient, et des clients aux attentes de conformité différentes. Ce qui a fonctionné, ce n’était pas « de meilleurs schémas d’architecture ». Ce qui a fonctionné, c’était la clarté opérationnelle : quels changements étaient autorisés, comment on les validait, ce qu’on monitorait, et comment on se remettait quand quelque chose passait au travers.
J’applique la même discipline dans ma construction de venture aujourd’hui — notamment sur des plateformes comme Shopeno et IBHQ, où la confiance, la justesse et le pilotage des coûts comptent. Les fonctionnalités IA donnent envie de livrer vite. Mais la seule IA qui dure, c’est celle qu’on sait exploiter : entrées versionnées, evals reproductibles, SLO explicites et un modèle d’autorité clair.
C’est aussi pour cela que j’aime emprunter des modèles mentaux à l’énergie et aux infrastructures. La bankability n’est pas une affaire d’optimisme. C’est une affaire de contrôles, de garanties et de plans de réponse. La même logique d’opérateur se retrouve dans ma manière d’évaluer le risque d’exécution sur des projets énergie (j’en ai écrit davantage dans The Operator’s Playbook for Making Grid-Scale Storage Bankable). L’IA a besoin de sa propre forme de bankability : une qualité de niveau décisionnel, un risque borné et des opérations prévisibles.
Les questions de board qui démasquent une « architecture de démo »
Si vous siégez dans un board, ou si vous portez un P&L, vous n’avez pas besoin de débattre des familles de modèles. Vous devez tester la préparation opérationnelle. Ces questions le révèlent rapidement :
- Qu’a le droit de faire l’IA ? Pas « qu’est-ce qu’elle peut faire » — qu’est-ce qui est autorisé en production ?
- Quels sont les SLO ? Latence, coût, fiabilité, qualité. Qui en est responsable ?
- Montrez-moi la suite d’evals. Quelles tâches ? Quels modes de défaillance ? À quelle fréquence ça tourne ? Qu’est-ce qui bloque une mise en production ?
- Quels changements déclenchent une re-qualification ? Modèle, prompt, corpus de retrieval, schéma d’outil, changements de policy.
- Où est le kill switch ? Qui peut l’activer ? Dans quelles conditions ? Quel est le workflow de repli ?
- Comment investigue-t-on un incident ? Quels logs existent ? Combien de temps sont-ils conservés ? Quelle posture privacy ?
- Quelle est la stratégie de rollout ? Advisory → sous garde-fous → autopilot, avec des gates explicites.
Si le leadership ne peut pas répondre sans approximations, l’« architecture » reste un schéma.
Mon avis, sans ambiguïté : construisez moins d’IA. Exploitez plus d’IA.
La discussion sur l’IA est saturée de frameworks, de stacks et de promesses éditeurs. Les opérateurs doivent rester résolument pragmatiques.
L’IA passe à l’échelle quand vous la traitez comme de la production. Donc : contrats plutôt qu’accès, evals plutôt qu’impressions, SLO plutôt qu’anecdotes, modes de contrôle plutôt qu’un « human-in-the-loop » générique, et gestion d’incident plutôt qu’espoir.
Si vous ne deviez retenir qu’une action pour ce trimestre, faites ceci : choisissez un cas d’usage IA qui touche les opérations réelles (triage du service, support achats, planification de maintenance, onboarding client). Puis mettez la checklist sur une page. Nommez des responsables. Affichez les SLO dans un dashboard. Faites un exercice d’incident. Vous apprendrez plus en 30 jours d’exploitation qu’en six mois à dessiner des schémas.
Voilà l’essentiel. L’architecture n’est pas ce que vous dessinez. C’est ce que vous savez faire tourner.
Newsletter
Des notes de terrain, directement dans votre boîte.
Des notes occasionnelles et sans bruit, prises de l'intérieur du travail : ce qui a été livré, ce qui a cassé, et ce que je ferais différemment.