26 October 2026 · 8 min de lecture
L’autopilot en trésorerie agentique doit avoir un kill switch : concevez-le comme une usine
Si vous voulez laisser l’IA déplacer de l’argent, vous devez l’ingénier comme une automatisation industrielle : autonomie sous contrôle, auditabilité rejouable et kill switch déjà testé.
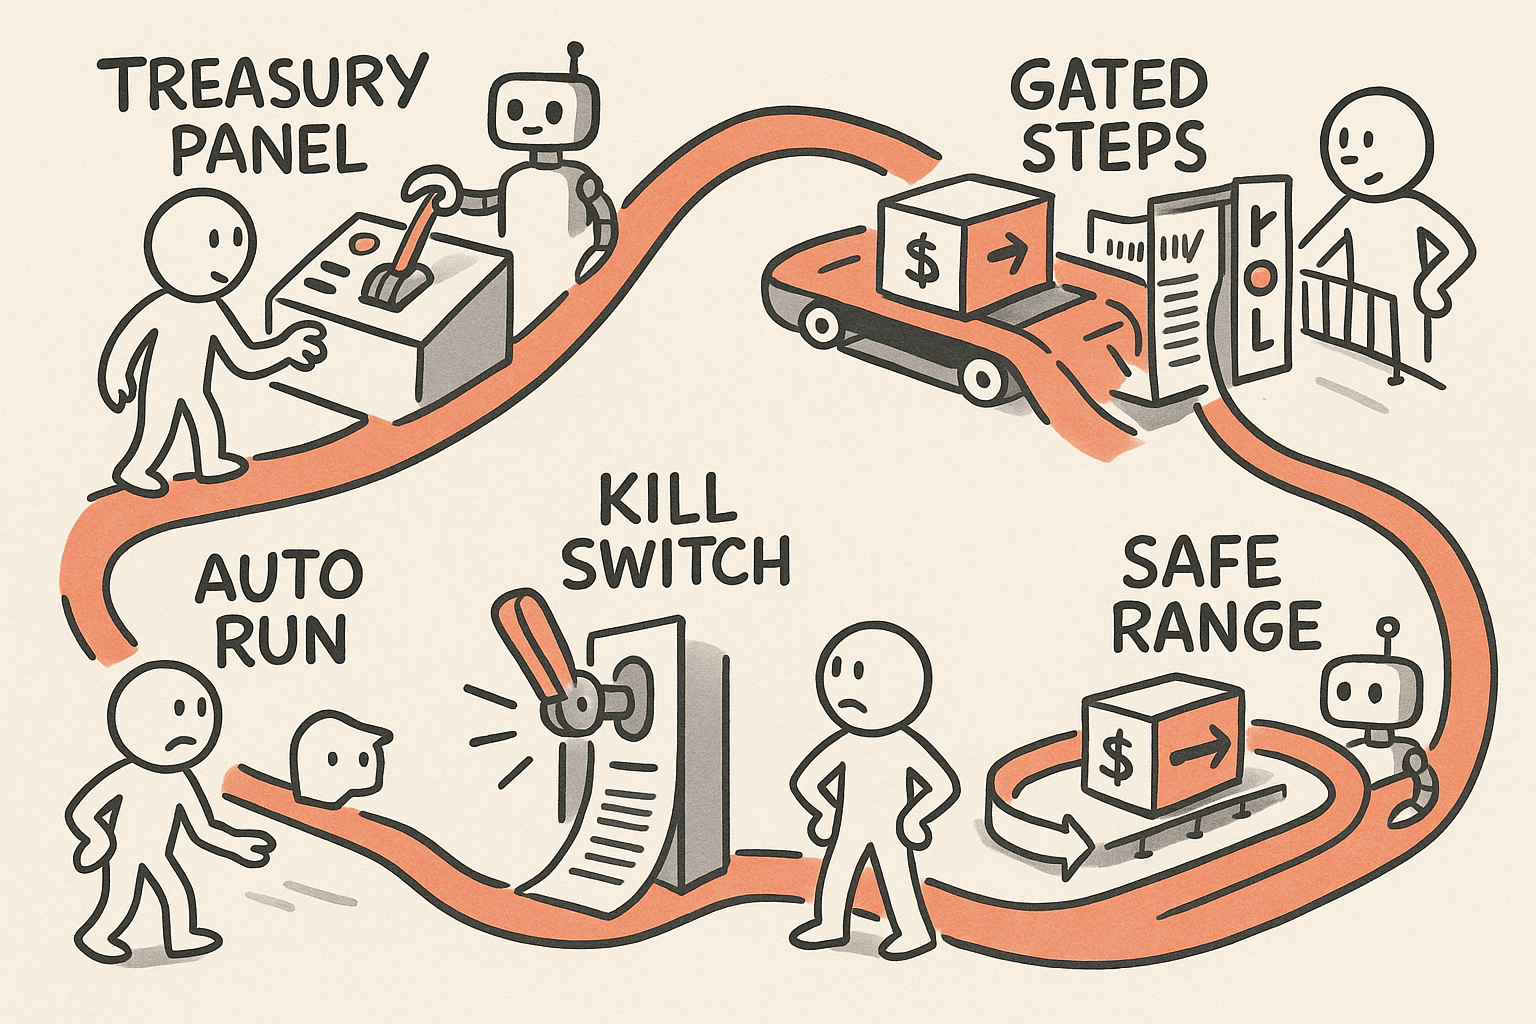
Je n’ai aucun problème avec l’autonomie. J’ai passé des années au contact de systèmes qui tournent sans demander la permission toutes les minutes. Des variateurs pilotent des moteurs. Des convertisseurs stabilisent des procédés. Des systèmes de GTB maintiennent le confort des occupants. Si on peut leur faire confiance, c’est parce qu’on les conçoit comme des usines : avec des enveloppes d’exploitation claires et des arrêts fermes.
La trésorerie s’approche du même point de bascule. L’IA agentique fait passer la promesse du « copilot » à l’« autopilot » sur des fonctions comme le cash positioning, la prévision, les paiements et le traitement des exceptions, comme le décrit l’analyse de Finextra sur l’impact de l’IA agentique en trésorerie. L’ambition se comprend. Le risque aussi : à la différence d’un rapport ou d’un dashboard, une action de trésorerie change le réel. Elle déplace des fonds, crée des expositions et déclenche des obligations contractuelles.
Mon avis est simple. Si vous ne pouvez pas arrêter l’agent en sécurité, vous ne devez pas le laisser piloter. La trésorerie agentique a besoin d’un kill switch, conçu comme on conçoit une autonomie sûre dans l’industrie : contrôles en couches, comportement auditable et arrêt répété en conditions réalistes.
Le sophisme de l’autopilot en trésorerie : « c’est du software, on patchera »
Dans les technologies industrielles, on part du principe que ça cassera. Pas parce que les équipes sont faibles, mais parce que la réalité est chaotique. Les capteurs dérivent. Les réseaux ont de la gigue. Les opérateurs improvisent. Les fournisseurs changent des composants. Si le process reste sûr, c’est parce qu’on encadre l’autonomie.
Quand je travaillais sur l’électronique de puissance pour l’automatisation, l’eau et l’assainissement, et le HVAC, nous ne traitions jamais une logique de contrôle comme « intelligente ». Nous la traitions comme responsable. Si une variable sortait des bornes, le système se dégradait proprement ou s’arrêtait. Il ne négociait pas. Il ne rationalisait pas. Il exécutait un comportement de sécurité défini.
L’IA agentique introduit un autre mode de défaillance. Ce n’est pas seulement une « mauvaise sortie ». C’est une « mauvaise action ». Elle peut aussi avoir raison pour de mauvaises raisons, ce qui complique les post-mortems si vous ne pouvez pas rejouer exactement la chaîne de décision.
Donc, avant de demander ce que l’agent peut faire, demandez-vous ce qu’il ne doit jamais faire. En trésorerie, la liste des « jamais » est souvent courte, et non négociable. C’est là que le design commence.
Concevez l’autonomie avec des gates, pas comme un continuum
On entend souvent : « on va commencer petit, puis augmenter l’autonomie ». Cela paraît raisonnable, mais cache un piège. Si l’autonomie est un continuum, les responsabilités se brouillent. Si l’autonomie est découpée en gates, vous obtenez des points de contrôle nets.
Voici un pattern que j’utilise, inspiré de la mise en service industrielle et adapté aux agents d’IA :
- Observe mode : l’agent lit les données et produit des recommandations. Aucun effet de bord. Tout est journalisé.
- Propose mode : l’agent prépare des artefacts exécutables (lots de paiements, suggestions de couverture, cash sweeps), mais ne peut pas les soumettre. Un humain approuve.
- Constrained execute mode : l’agent exécute dans des limites strictes (montant, contrepartie, devise, fenêtre temporelle, objet). Les exceptions repartent dans une file.
- Supervised autopilot : l’agent exécute dans une enveloppe plus large, mais sous monitoring en temps réel et avec des conditions de déclenchement automatiques.
L’essentiel : chaque gate a des critères d’entrée explicites et un rollback explicite. Si vous ne pouvez pas décrire la gate en une page, vous n’avez pas une gate. Vous avez un vœu pieux.
C’est aussi là que la plupart des démarches « AI governance » finissent en réunions. Je préfère construire le système d’exploitation. Si vous cherchez un angle pratique, mon texte sur l’architecture IA comme checklist d’opérateur applique la même logique aux choix de design technique.
Auditabilité rejouable : l’équivalent trésorerie d’un enregistreur de vol
En production et en opérations industrielles, on ne débugge pas de mémoire. On débugge sur des traces. On regarde les événements, les timestamps, les valeurs capteurs, les consignes, les actions opérateur et les alarmes.
La trésorerie doit adopter la même discipline dès qu’un agent intervient. « Le modèle l’a suggéré » n’est pas une piste d’audit. « L’agent l’a exécuté » n’est pas une explication.
Par auditabilité rejouable, j’entends : pouvoir reconstruire de façon déterministe ce que l’agent a vu et ce qu’il a fait. Pas avec des captures d’écran. Avec des logs structurés. Vous devez pouvoir répondre à des questions comme :
- Quelles sources de données ont été utilisées pour cette décision, et quels étaient leurs timestamps ?
- Quelles règles de policy étaient actives (limites, approbations, séparation des tâches) ?
- Quels appels d’outils ont été faits (ERP, TMS, API bancaires) et quelles réponses ont été reçues ?
- Quels signaux d’incertitude ou de confiance étaient disponibles, et quels seuils s’appliquaient ?
- Quelles actions alternatives ont été envisagées puis écartées, et pour quelles raisons ?
Quand je dirigeais une business unit internationale dans les smart-building controls, les objets connectés déclenchaient des discussions sans fin — des « peut-être » — tant qu’on n’avait pas une télémétrie nette et des event logs solides. Dès que le comportement est devenu observable, la fiabilité est devenue une discipline d’exploitation, plus un débat. La trésorerie agentique suivra la même trajectoire.
Concrètement, je veux deux artefacts pour chaque action autonome :
- Un execution record : ce qui a été fait, quand, avec quelle identité et quelles permissions.
- Un decision record : les inputs, contraintes et rationnel qui y ont conduit, capturés de façon rejouable.
Si vous ne pouvez pas rejouer, vous ne pouvez pas améliorer. Et si vous ne pouvez pas expliquer, vous ne devez pas automatiser.
Le kill switch : pas un bouton, une procédure testée
Beaucoup d’équipes traitent le kill switch comme un élément d’interface. Un toggle. Un gros bouton rouge. Dans l’industrie, un mécanisme d’arrêt est un design complet : où il est câblé, ce qu’il interrompt, dans quel état on met le système, et comment on redémarre.
Un kill switch de trésorerie doit couvrir plus que « stopper les actions futures ». Il doit gérer les actions en cours, les soumissions partielles et la réconciliation. Sinon, vous arrêtez l’agent, mais vous récupérez quand même le rayon d’explosion.
Voici le design minimum viable que je recommande aux boards et aux équipes :
- Trois voies d’arrêt indépendantes : pause au niveau applicatif, révocation des identifiants (API keys, tokens) et contrôles côté banque (limites, whitelists, call-backs). L’indépendance est clé : une couche défaillante ne doit pas empêcher l’arrêt.
- Conditions de déclenchement automatiques : volumes inhabituels, nouveaux bénéficiaires, activité hors fenêtre, retries répétés, écarts de réconciliation, violations de fraîcheur des données. Ne comptez pas sur les humains pour détecter une dérive.
- Définition d’un safe state : que deviennent les lots en attente, les approbations en file, les retries après l’arrêt. Le safe state doit être explicite.
- Runbook de reprise : qui vérifie quoi, et dans quel ordre, avant de réactiver l’autonomie. Incluez les étapes de communication. Incluez la réconciliation.
- Fire drills trimestriels : vous simulez un scénario dégradé et vous tirez l’arrêt. Si vous ne le testez jamais, il échouera quand vous en aurez besoin.
C’est le même réflexe que j’avais quand j’étais responsable des opérations en électrification et en stockage d’énergie. On ne découvre pas sa procédure d’urgence pendant l’urgence. On l’entraîne jusqu’à ce qu’elle devienne un réflexe organisationnel.
Le moyen le plus rapide de rendre cela concret consiste à traiter l’agent comme un actif de ligne de production. Donnez-lui un owner. Un plan de maintenance. Des alarmes et une escalade. Un protocole d’arrêt. Sinon, il se comportera comme du shadow IT… avec une connexion bancaire.
Un cadre de décision au niveau board, applicable ce trimestre
Si vous siégez dans un board, ou si vous pilotez la trésorerie, vous n’avez pas besoin d’un débat sur les modèles. Vous avez besoin d’une décision de contrôle. Voici la checklist que j’utiliserais en comité d’approbation :
- Scope : quelles décisions l’agent a-t-il le droit de prendre, et lesquelles restent définitivement réservées à l’humain ?
- Envelope : quelles sont les limites dures (montant, contrepartie, devise, timing, objet) ?
- Observability : peut-on rejouer toute action autonome de bout en bout en moins de 24 heures ?
- Separation of duties : qui peut modifier les policies, qui peut déployer, qui peut approuver les exceptions, qui peut l’arrêter ?
- Stop design : a-t-on des voies d’arrêt indépendantes, un comportement de safe state et un runbook de reprise ?
- Drills : quand a lieu le prochain test du kill switch, et qui valide les résultats ?
Si vous ne répondez pas clairement à ces six points, ne déployez pas l’« autopilot ». Restez en propose mode et durcissez le système.
C’est aussi pour cela que je fais le parallèle avec la bankability dans les infrastructures. Dans l’énergie, on n’obtient pas de financement en promettant la performance. On l’obtient en prouvant les contrôles et la maîtrise du downside. La même logique s’applique à l’autonomie en finance. J’ai écrit sur cet état d’esprit dans « making grid-scale storage bankable ». Industrie différente, même math d’opérateur.
Mon point de vue : l’autonomie se mérite, elle ne s’active pas
L’IA agentique peut réellement créer de la valeur en trésorerie. Mais uniquement si vous la traitez comme un process industriel, pas comme une feature. Une autonomie découpée en gates vaut mieux qu’une autonomie large. Le replay vaut mieux que les impressions. Un kill switch testé vaut mieux qu’un document de policy.
Si vous voulez les bénéfices, il faut payer les contrôles. C’est le deal. Dans mon expérience, les équipes qui l’acceptent tôt vont plus vite ensuite, parce qu’elles passent moins de temps à discuter et plus de temps à exécuter en sécurité.
L’autopilot n’est pas une capacité. C’est un système de contrôle avec une procédure d’arrêt.
Construisez-le comme une usine, et vous pourrez le laisser tourner. Construisez-le comme un chatbot, et vous serez tôt ou tard contraint de l’arrêter.
Newsletter
Des notes de terrain, directement dans votre boîte.
Des notes occasionnelles et sans bruit, prises de l'intérieur du travail : ce qui a été livré, ce qui a cassé, et ce que je ferais différemment.