26 October 2026 · 9 min de lecture
L’adoption de l’IA tient d’abord à la propriété des workflows, pas aux modèles
Si vous voulez que l’IA fasse bouger les chiffres, industrialisez les relais humains–IA comme vous industrialiseriez la qualité sur une ligne de production.
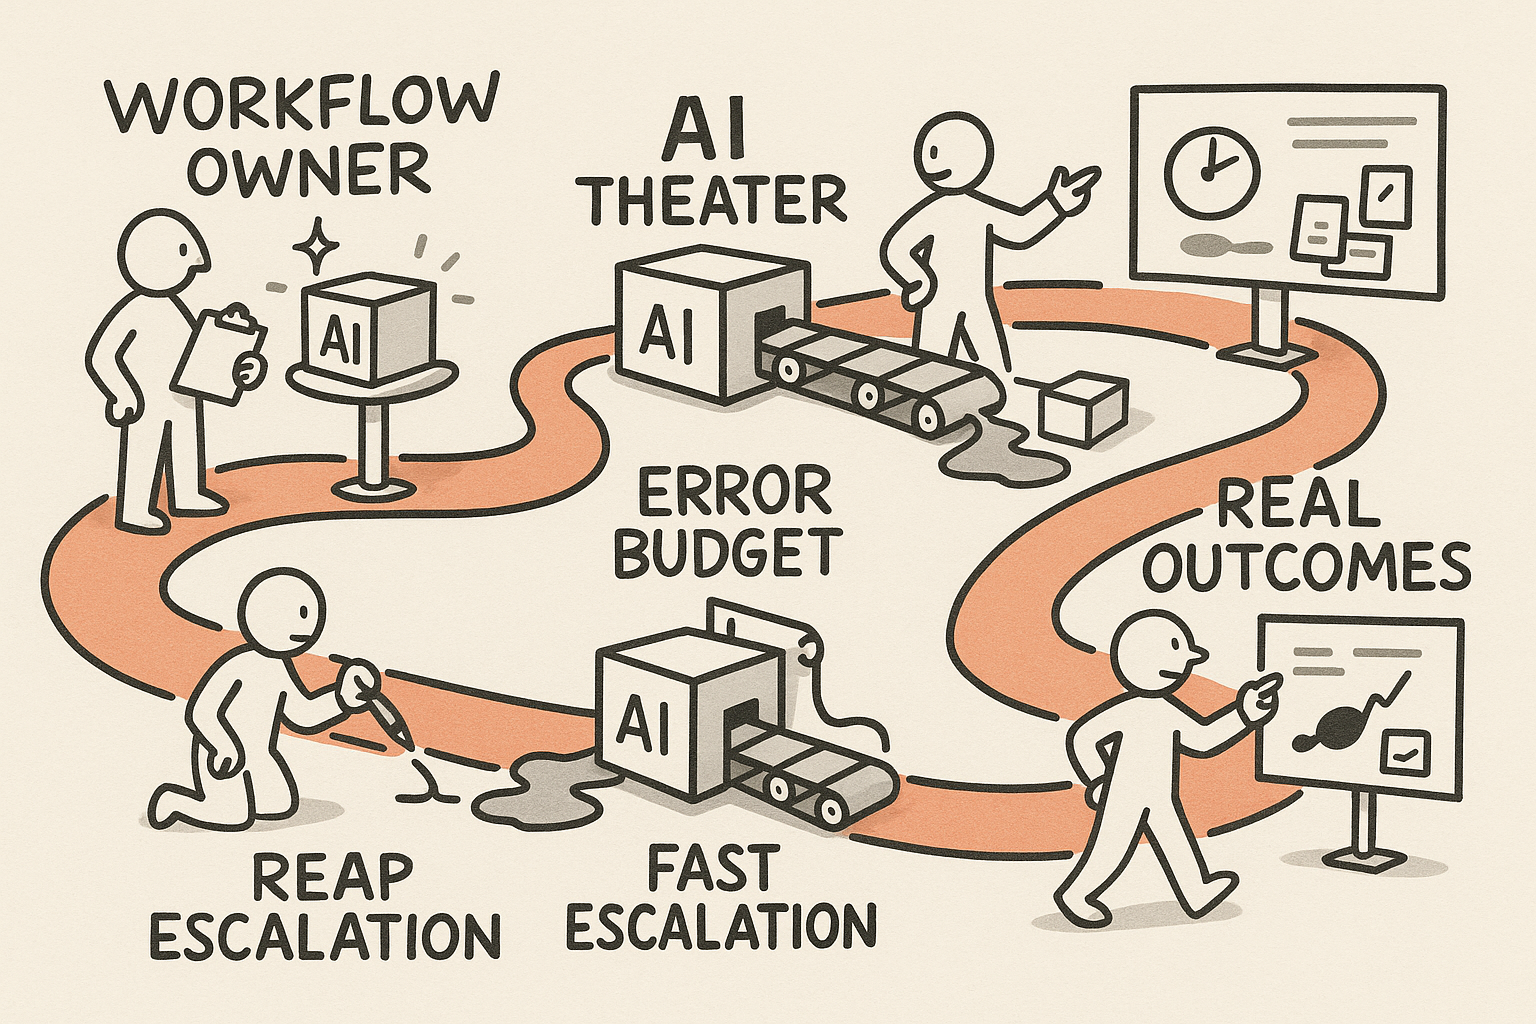
J’ai un test simple pour savoir si une organisation est sérieuse sur l’IA (intelligence artificielle) : pouvez-vous désigner le propriétaire du workflow ?
Pas le product owner d’un chatbot. Pas le responsable data. L’opérateur qui possède le processus de bout en bout, le budget d’erreur, et la voie d’escalade quand l’IA se trompe.
Au Danemark, la différence entre « AI theatre » et IA opérationnelle se voit dans la manière dont un grand assureur a traité l’IA comme de nouveaux collègues qui prennent en charge les tâches routinières, libérant du temps pour les équipes. Rien de spectaculaire. Des années d’optimisation de workflows, une tâche répétitive après l’autre, avec amélioration continue et ownership clair.
C’est ce que je veux voir davantage de boards et d’opérateurs intégrer. L’« adoption de l’IA », c’est d’abord l’ownership du workflow, plus des contrôles. Les contrôles, ce n’est pas un comité. C’est exactement ce que l’industrie a appris à faire depuis des décennies : des relais définis, des défauts définis, et une escalade rapide. Ensuite, on mesure ce qui compte : temps de cycle des sinistres, fuites de valeur et taux de réclamations. Pas les applaudissements en démo.
Le recadrage d’opérateur : l’IA est un poste dans votre processus
Quand j’ai passé onze ans dans l’électronique de puissance, la qualité n’était jamais un sujet de PowerPoint. C’était une réalité de production. Vous conceviez la ligne pour que le bon travail se fasse au bon poste, avec des critères d’acceptation clairs. Si une unité échouait, vous ne faisiez pas un débat d’idées. Vous conteniez, vous retouchiez, et vous traitiez la cause racine.
La plupart des programmes IA n’ont pas ce réflexe industriel. Ils partent d’un modèle, puis cherchent un cas d’usage. Les opérateurs font l’inverse. Ils partent d’un workflow existant, avec des irritants connus : backlog, retouches, frustration client ou fuites de valeur. Ensuite, ils décident où l’IA peut jouer le rôle d’un poste, et à quoi ressemble le « bon » à ce poste.
Trois conséquences très concrètes :
- L’IA ne « transforme » pas une fonction. Elle modifie des relais précis. C’est là que ça gagne ou que ça se perd.
- La sortie de l’IA n’est pas une décision. C’est une entrée dans une chaîne de décision, avec une responsabilité explicite.
- Les contrôles ne sont pas une surcharge. Ils rendent le débit soutenable.
C’est aussi pour cela que je reviens souvent à une lecture « checklist d’opérateur » de l’IA. Si vous voulez un cadrage plus technique, j’ai écrit un article complémentaire sur pourquoi l’architecture IA est une checklist d’opérateur. Le même état d’esprit s’applique ici, mais au niveau du workflow.
Définissez les relais humains–IA, puis posez les règles
Si vous ne faites qu’une chose ce trimestre, faites celle-ci : cartographiez un workflow de bout en bout et marquez chaque point où le travail change de mains. Humain vers humain. Système vers humain. Humain vers système. Puis décidez où se place l’IA, et quoi faire lorsqu’elle est incertaine.
J’emploie volontairement le vocabulaire de l’industrie, parce qu’il impose la clarté. Dans une usine, vous ne diriez jamais : « le poste se débrouillera ». Vous le spécifiez.
Pour le travail de connaissance, l’équivalent est un court jeu de règles d’exploitation :
- Critères d’entrée : quels inputs sont nécessaires pour que l’IA agisse ? Quel est le minimum de complétude des données ? Quelle fraîcheur est acceptable ?
- Critères de sortie : à quoi ressemble une sortie acceptable ? Quels champs doivent être renseignés ? Quelles preuves doivent être jointes ?
- Conception du relais : quand l’IA auto-renseigne, quand elle propose un brouillon, quand elle ne fait que recommander ? Qui valide ?
- Budget d’erreur : quels types d’erreurs sont tolérables, et à quel taux ? Quelles erreurs sont inacceptables ?
- Voie d’escalade : où va le travail incertain ? En combien de temps ? Vers qui ? Avec quel contexte ?
C’est là que la plupart des efforts d’adoption de l’IA meurent discrètement. Non parce que le modèle est faible, mais parce que personne ne veut porter les détails inconfortables. Surtout le budget d’erreur.
Budgets d’erreur : arrêtez de prétendre que vous allez « supprimer les erreurs »
Tout processus réel produit des défauts. La question d’opérateur n’est pas de savoir s’il y a des défauts. Elle est de savoir si vous avez conçu le dispositif pour les gérer.
Quand je pilotais des opérations dans des contextes industriels, nous utilisions des définitions claires des défauts et des mécanismes de containment. En R&D et en QA, nous traitions la qualité comme une propriété du système : prévention, détection, correction. Vous n’obtenez pas un résultat robuste en demandant aux gens « d’être prudents ». Vous l’obtenez en rendant l’action suivante évidente et rapide.
L’IA doit être traitée de la même manière. Définissez quelques catégories utiles opérationnellement :
- Erreurs critiques : action incorrecte avec impact client, risque réglementaire ou perte financière. Elles exigent des garde-fous stricts et une validation humaine.
- Erreurs coûteuses : problèmes qui génèrent des retouches, des délais ou des fuites de valeur. Elles exigent de l’échantillonnage, des seuils, et des mises à jour rapides du modèle ou des règles.
- Erreurs cosmétiques : mise en forme, formulation, légère dérive de classification. Elles ne doivent pas bloquer le flux.
Puis transformez cela en politique explicite : en dessous d’un niveau de confiance X, on route vers une revue humaine. Pour le type de dossier Y, jamais d’action automatique. Si les données sont incomplètes, on demande les champs manquants avant de poursuivre. Ce n’est pas glamour. C’est efficace.
Les boards demandent souvent : « Quel est le risque ? » La meilleure question est : « Quelle réponse avons-nous conçue quand l’IA se trompe ? » Si vous ne pouvez pas répondre, vous n’avez pas un système d’IA. Vous avez un prototype en production.
Mesurez l’adoption comme un opérateur : temps de cycle, fuites de valeur, taux de réclamations
Si vous mesurez l’IA au nombre de pilotes, vous obtiendrez des pilotes. Si vous la mesurez à la satisfaction en démo, vous obtiendrez de belles démos. Les opérateurs mesurent le débit et la qualité.
Dans la gestion de sinistres, cela veut dire des métriques comme le temps de cycle, les fuites de valeur et le taux de réclamations. En industrie, c’est le first-pass yield, la casse et les retours. En SaaS, c’est le temps de résolution, la déflexion de tickets sans nouveau contact, et des signaux de churn. Le domaine change. La logique d’opérateur est identique.
Voici un set de KPI très transposable :
- Temps de cycle : médiane et 90e percentile entre l’entrée et la décision.
- Taux de retouches : pourcentage de dossiers qui repartent en arrière après une étape IA ou humaine.
- Proxy de fuite de valeur : toute « valeur perdue » mesurable dans le processus (surpaiement, sous-facturation, recouvrements manqués, remises accordées, déplacement inutile).
- Taux de réclamations : normalisé par volume, avec des niveaux de gravité.
- Volume d’escalades : fréquence à laquelle l’IA déclenche une revue humaine, et pourquoi.
Deux indicateurs servent de système d’alerte précoce : les retouches et les escalades. Quand ils montent, on ne débat pas. On enquête sur le poste : qualité des inputs, logique des prompts, dérive du modèle, comportements utilisateurs ou politique floue. Puis on corrige le processus.
Exemple vécu : je l’ai appris à la dure en construisant et en faisant grandir des équipes
Quand j’ai reconstruit et fait grandir une organisation R&D jusqu’à environ 22 spécialistes (embedded software, cloud, électronique, mécanique et QA), le facteur limitant était rarement le talent brut. C’étaient les interfaces. Qui possédait le relais entre l’électronique et le firmware ? Qu’est-ce que « done » pour un release candidate ? Que se passe-t-il quand la QA trouve tard un problème systémique ?
Le jour où nous avons posé les critères d’acceptation et les voies d’escalade, le débit s’est amélioré. La qualité aussi. La pression a baissé. Non parce que les équipes travaillaient moins, mais parce que l’ambiguïté reculait.
J’applique le même raisonnement aujourd’hui dans mes ventures. Quand je construis des produits comme IBHQ ou Shopeno, je traite l’IA appliquée comme une partie de l’operating system : ce qu’elle a le droit de faire, ce qu’elle ne doit jamais faire, et quelles preuves elle doit joindre pour qu’un humain puisse vérifier ou surclasser rapidement. Le gain n’est pas « de l’IA partout ». Le gain, ce sont moins de relais ambigus et des décisions plus rapides, sous contrôle.
C’est aussi pour cela que je ne m’enthousiasme pas quand on me dit qu’on a « déployé l’IA dans l’organisation ». Je demande : quel workflow, quel poste, quel budget d’erreur, quel owner d’escalade, quel indicateur a bougé ?
La checklist board et opérateur pour ce trimestre
Si vous voulez un plan concret, exécutable en 90 jours, utilisez cette checklist.
- Choisissez un workflow avec du volume. Ouverture de sinistres. Rapprochement de factures. Triage du support client. Onboarding fournisseurs. Un workflow, pas un département.
- Nommez le propriétaire du workflow. Une personne accountable sur le flux de bout en bout et les résultats.
- Cartographiez les postes et les relais. Où le travail change-t-il de mains, et où se bloque-t-il ?
- Insérez l’IA comme un poste, pas comme une couche. Définissez les critères d’entrée et de sortie.
- Écrivez le budget d’erreur et la voie d’escalade. Incluez les cas « never auto-act ».
- Instrumentez les métriques. Temps de cycle, retouches, proxy de fuite de valeur, taux de réclamations.
- Tenez des revues ops hebdomadaires. Comme une réunion de production. Principaux défauts. Principales escalades. Causes racines. Correctifs livrés.
Si vous cherchez un modèle mental venant d’un autre domaine : dans l’énergie à l’échelle réseau, la bankability se construit sur des contrôles et une performance prévisible. Cette même discipline d’opérateur explique pourquoi j’ai écrit un playbook pour rendre le stockage à l’échelle réseau bankable. L’IA ne fait pas exception. La confiance se conçoit.
Mon avis : arrêtez d’acheter de l’IA. Commencez à l’opérer.
Le cas danois est « ennuyeux » au meilleur sens du terme. Des années à optimiser les workflows et à libérer du temps en confiant à l’IA des tâches routinières, non comme une magie, mais comme une capacité de production que l’on améliore en continu.
C’est le standard que je veux voir les boards exiger. Pas un lab d’innovation. Pas une pile de pilotes. Un propriétaire de workflow identifié. Des relais définis. Des budgets d’erreur. Des escalades. Et des métriques qui impactent le P&L et l’expérience client.
Quand vous faites cela, les modèles deviennent presque la partie facile. La partie difficile, c’est le leadership : assumer le workflow comme si c’était votre ligne de production, parce que c’en est une.
Newsletter
Des notes de terrain, directement dans votre boîte.
Des notes occasionnelles et sans bruit, prises de l'intérieur du travail : ce qui a été livré, ce qui a cassé, et ce que je ferais différemment.