20. oktober 2026 · 7 min read
En ikke-ideologisk “lean” playbook: Hvornår færre mennesker faktisk leverer mere
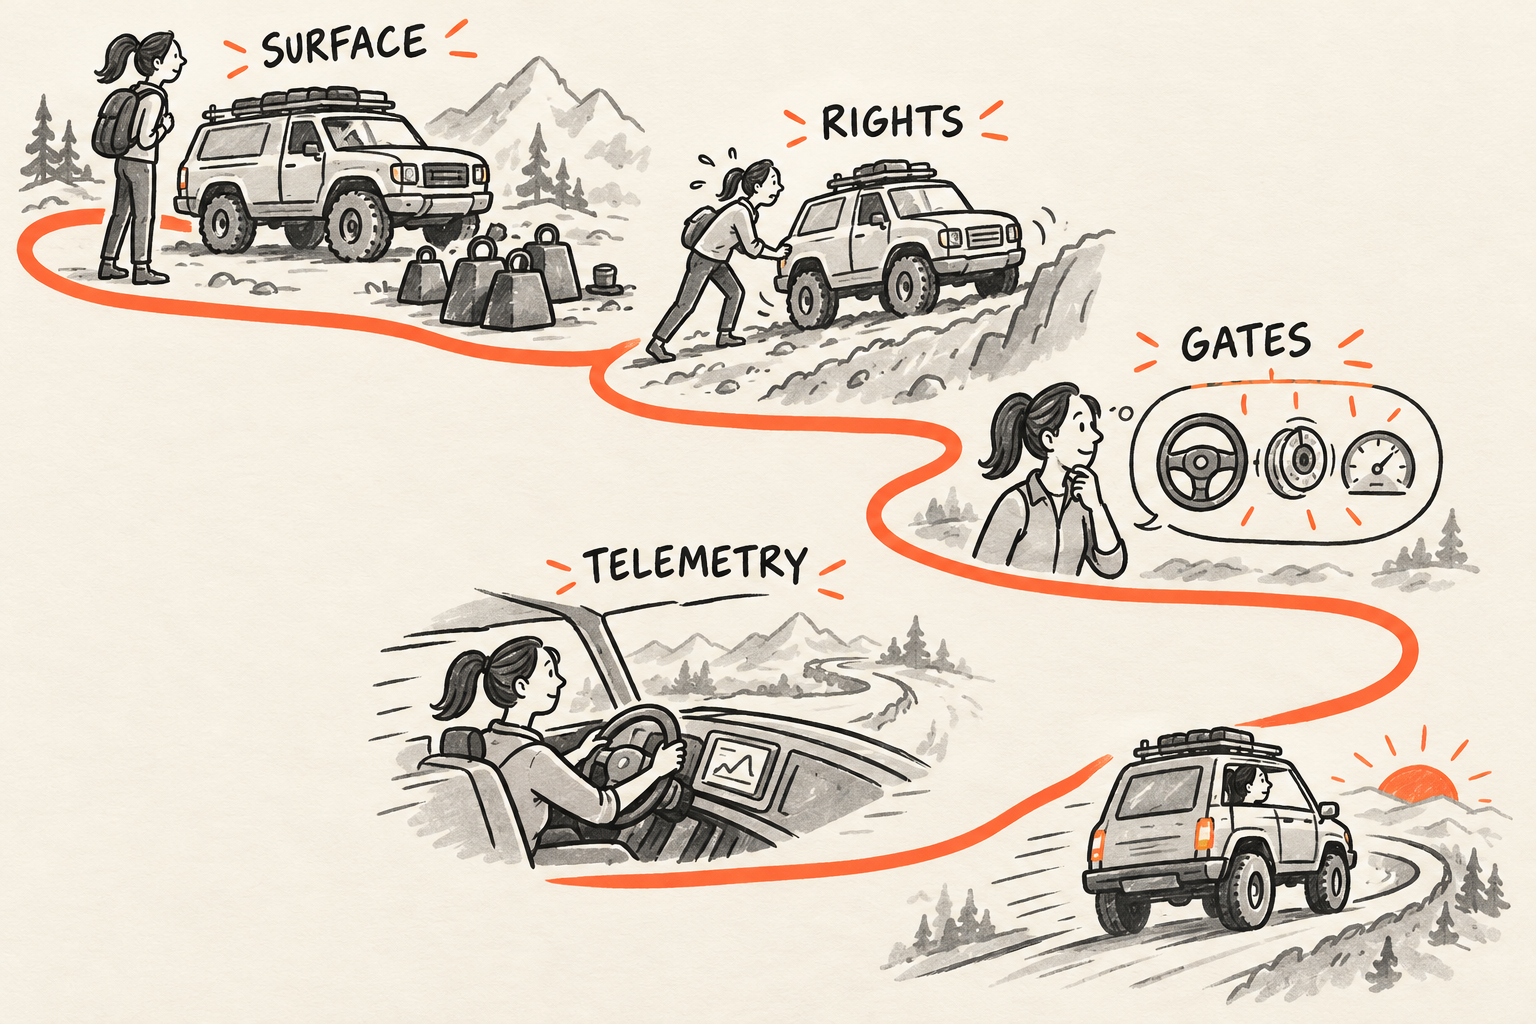
Headcount-kut øger kun tempoet, når du reducerer surface area, skærper decision rights, strammer quality gates og instrumenterer arbejdet, så fejl ikke kan gemme sig.
Hvert par år vender “lean” tilbage som en moralsk fortælling. Store teams blev magelige. Små teams er sultne. Skær 10%, 20%, 75% og på en eller anden måde bliver produktet bedre.
Nogle gange passer den historie. Ofte er den bare ufuldstændig.
Det jeg har lært på den hårde måde, er at lean ikke er en størrelse. Det er et operating design. Fjerner du mennesker uden at ændre designet, får du ikke højere throughput. Du får en mere stille form for kaos: flere eskalationer, mere rework, langsommere beslutninger og en voksende bunke kundevendte “paper cuts”, som ingen ejer.
Den seneste snak om headcount-kut i SaaS er en god anledning til at være præcis. Argumentet, der kører lige nu, er at virksomheder skærer dybt, og derefter vokser hurtigere eller tjener mere—så teams kan være meget mindre, end vi tror. Eksemplet, der bliver citeret, er et nyt “Core”-team, som leverede “30+ top customer requests in 3 weeks”, sammen med nyetablerede performance- og infra-teams, i konteksten af store layoffs hos Airtable under Bending Spoons (“30+ top customer requests in 3 weeks” og påstanden om lean-teams).
Jeg er ikke interesseret i ideologien. Jeg er interesseret i mekanikken. Her er den playbook, jeg ville bruge til at vurdere, før du cutter, om “lean” reelt vil øge velocity—eller bare flytte omkostninger over i fejl, du betaler for senere.
1) Reducér product surface area, ellers redistribuerer du bare smerte
Headcount-kut virker kun, når workload-grafen bliver enklere. Hvis surface area er den samme, har du ikke skabt fokus. Du har skabt kø.
Surface area er ikke kun antal features. Det er:
- Hvor mange user journeys du lover forbliver stabile.
- Hvor mange integrationer du understøtter som “first-class”.
- Hvor mange tiers, planer og specialaftaler du bærer rundt på.
- Hvor mange interne platforme og pipelines du forventer, at folk forstår.
Hvis du vil have mindre teams til at levere mere, kræver det to eksplicitte greb:
- Beslut hvad der er frosset. Ikke “senere”. Frosset. Ingen roadmap-slots, ingen refactors, ingen “quick wins”.
- Slet commitments, ikke kun tasks. Nedlæg en plan, konsolidér SKUs, deprecate en integration, fjern et customization-niveau. Det er her kapaciteten kommer fra.
Mange virksomheder cutter og bliver derefter overraskede over, at support tickets stiger. Det er ikke overraskende. Det er matematik. Du beholdt det samme sæt løfter, med færre hænder, og du indsnævrede ikke blast radius.
En praktisk test: list jeres top 25 kilder til kompleksitet, og spørg derefter hvilke ti I kan dræbe på et kvartal uden at sætte virksomheden i fare. Hvis det ærlige svar er “ingen”, så gør et dybt cut dig ikke lean. Det gør dig skrøbelig.
2) Decision rights skal blive skarpere, ikke mere “collaborative”
Lean teams vinder ikke, fordi hver enkelt er en helt. De vinder, fordi omkostningen ved at beslutte er lav.
Efter et cut gør de fleste virksomheder ved et uheld det modsatte. De centraliserer beslutninger for at “reducere risiko”, eller de indfører flere review-trin, fordi der er færre specialister tilbage. Begge dele øger time-to-yes. Leverancer går langsommere, selv hvis folk arbejder hårdere.
Det, der i stedet skal være sandt:
- Hver product slice har én accountable owner. Ikke en komité. Ét navn på resultatet.
- Interfaces har også owners. Hvis “Core” leverer hurtigt, er det typisk fordi edge cases er skubbet ud til en grænse med klare regler. Grænser kræver stewardship.
- Der findes en offentlig eskalationsvej. Hvis en beslutning ikke kan træffes på 24 til 48 timer, skal alle vide, hvor den går hen som det næste.
Et nyttigt mønster er at adskille “hvad” fra “hvordan”. Lad product leadership sætte mål og guardrails. Lad teamet vælge metoden. Blander du dem, bliver hver tradeoff personlig, og hvert møde bliver en forhandling.
Lean uden decision clarity bliver politik med mindre empati. Det er en af de hurtigste måder at miste dine bedste folk på, efter du allerede har skåret.
3) Quality gates skal strammes, ellers finansierer du skjult failure demand
Her er paradokset: Når I er færre mennesker, har I ikke råd til “move fast and fix later”. “Later” kommer aldrig, fordi det samme mindre team nu bærer fixes, roadmap og eskalationer.
Det er her de fleste “lean transformations” fejler stille og roligt. De måler output som leverede tickets, og ignorerer halen af oprydningsarbejde, som de tickets skaber.
Gør quality gates eksplicitte og ikke-til-forhandling:
- Definition of done, der inkluderer operability. Monitoring, alerts, runbook, rollback path. Hvis det ikke kan driftes/supporteres, er det ikke done.
- Release gates, der stopper repeat offenders. Hvis et modul skaber incidents, får det strengere checks, indtil det opfører sig stabilt.
- Automation hvor det betaler husleje. Test suites er ikke dyd. De er forsikring. Køb den forsikring, der dækker dine største risici.
Jeg har set QA blive til en forhandling, når deadlines strammede. Den umiddelbare gevinst var fart. Den forsinkede pris var en voksende strøm af “små” defects, der stjal uger hen over et kvartal. Læren var enkel: Du kan ikke skære dig til fart, hvis du samtidig skærer de mekanismer væk, der forhindrer rework.
Lean teams er ikke sjuskede. De er disciplinerede omkring, hvad der får lov til at komme i production, fordi det er i production, tiden forsvinder.
4) Operationel telemetry skal være god nok til at lukke diskussioner
Når teams bliver mindre, mister du redundans. Det betyder, at du har brug for tidligere signaler. Hvis du først finder ud af, at noget er gået i stykker, når kunden klager, er du ikke lean. Du er blind.
Telemetry er ikke et dashboard-projekt. Det er det minimum af signaler, der gør, at du kan svare på fire spørgsmål uden debat:
- Hvor går tiden hen? Lead time fra idé til production, og ventetid pr. stage.
- Hvor lækker kvalitet? Incidents, rollbacks, defect escape rate og support ticket-kategorier, der mappes til produktområder.
- Hvor stiger belastningen? On-call pages, queue depth, customer success-eskalationer, sales engineering-træk.
- Hvad stoppede vi med at gøre? En synlig liste over de-scopes og deprecations, så organisationen ikke genintroducerer dem ad bagdøren.
Det er den ikke-indlysende del. Hvis du vil have headcount-kut til at øge velocity, skal du investere i måling. Ellers bliver hver missede deadline til en historie, og den højeste historie vinder.
Hvis du bruger AI i engineering eller support, bliver telemetry endnu vigtigere. Automation kan skabe sin egen version af failure demand—bare hurtigere. Jeg skrev om den dynamik i The CFO-Grade Playbook to Prevent Agentic COGS Shock, fordi omkostning og kvalitet driver sammen, når feedback-loopet er svagt.
5) Genopbyg team-topologien omkring flow, ikke org charts
De fleste reorganiseringer efter et cut er kosmetik. Bokse flytter. Arbejdet forbliver filtret ind i hinanden.
Hvis du vil have små teams til at levere “mere og bedre”, skal strukturen afspejle, hvordan arbejdet faktisk flyder:
- Et lille antal value streams. Hver stream ejer outcomes, ikke komponenter.
- Én platform-gruppe, der gør resten hurtigere. Ikke et “catch-all infra team”, men en fokuseret enablement-funktion med en backlog koblet til sparet udviklertid og undgåede incidents.
- En tydelig intake-mekanisme. Requests kommer ikke ind via Slack. De kommer ind via en triage-path med regler.
Derfor er “Core plus performance og infra”-splittet, som nævnes i Airtable-eksemplet, interessant (Core-team plus performance- og infra-teams). Den topologi kan fungere, men kun hvis interfaces er knivskarpe. Ellers bliver Core en magnet for alle urgente requests, og de andre grupper ender som ticket-processorer.
En enkel regel: Hvis et team ikke kan sige nej, er det ikke et team. Det er en kø.
Hvad du kan gøre i dette kvartal: “Lean Readiness”-checklisten
Hvis du er founder, ejer eller seniorleder, så behandl “lean” som en engineering change. Du har brug for prerequisites, ikke slogans.
- Surface area: Hvad vil du fryse, retire eller konsolidere de næste 90 dage?
- Decision rights: For hver stream: hvem er den ene accountable person, og hvilke beslutninger må de tage alene?
- Quality gates: Hvad skal være sandt før release, og hvad er konsekvensen, når det ikke er sandt?
- Telemetry: Hvilke fire til seks metrics vil lukke diskussioner om speed, kvalitet og load?
- Topologi: Hvilke teams ejer outcomes, hvilket team enable’r, og hvordan kommer arbejde ind i systemet?
Hvis du ikke kan svare klart på det, kan et cut godt forbedre kortsigtede margins, men det forbedrer ikke throughput. Det omprissætter bare det samme arbejde til afbrydelser og churn-risiko.
Min vurdering: lean er et constraint-system, ikke et headcount-mål
Små teams kan absolut levere mere. Jeg har set det ske. Men den kausale mekanisme er ikke “pres”. Det er design.
At skære i mennesker er den nemme del. Den svære del er at bygge en virksomhed, hvor færre mennesker trygt kan træffe flere beslutninger, med færre overraskelser, på tværs af et mindre sæt løfter.
Gør du det, bliver lean en fordel. Springer du over, betaler du stadig for arbejdet. Du betaler bare det mest ineffektive sted: efter det går i stykker.
Hvis det her står på din agenda, er næste skridt ikke at diskutere en procent. Det er at redesigne systemet, så hastigheden er reel og gentagelig.
Relateret: Den samme logik gælder, når du introducerer agentic coding eller automatiserede ændringer. Release pipeline bliver produktet. Default-On Agentic Coding Is a Release Pipeline Change, Not a Feature Toggle går dybere i de controls, du har brug for.
Nyhedsbrev
Arbejdsnoter direkte i indbakken.
Lejlighedsvise, støjfri noter om ledelse, eksekvering og anvendt AI — fra banen, ikke fra sidelinjen.