14. oktober 2026 · 7 min read
AI DR-runbook’en, som ledelser bliver ved med at glemme
Design graceful degradation for AI-features: klare RTO/RPO, fallback-modes og en kill switch, der redder workflowet.
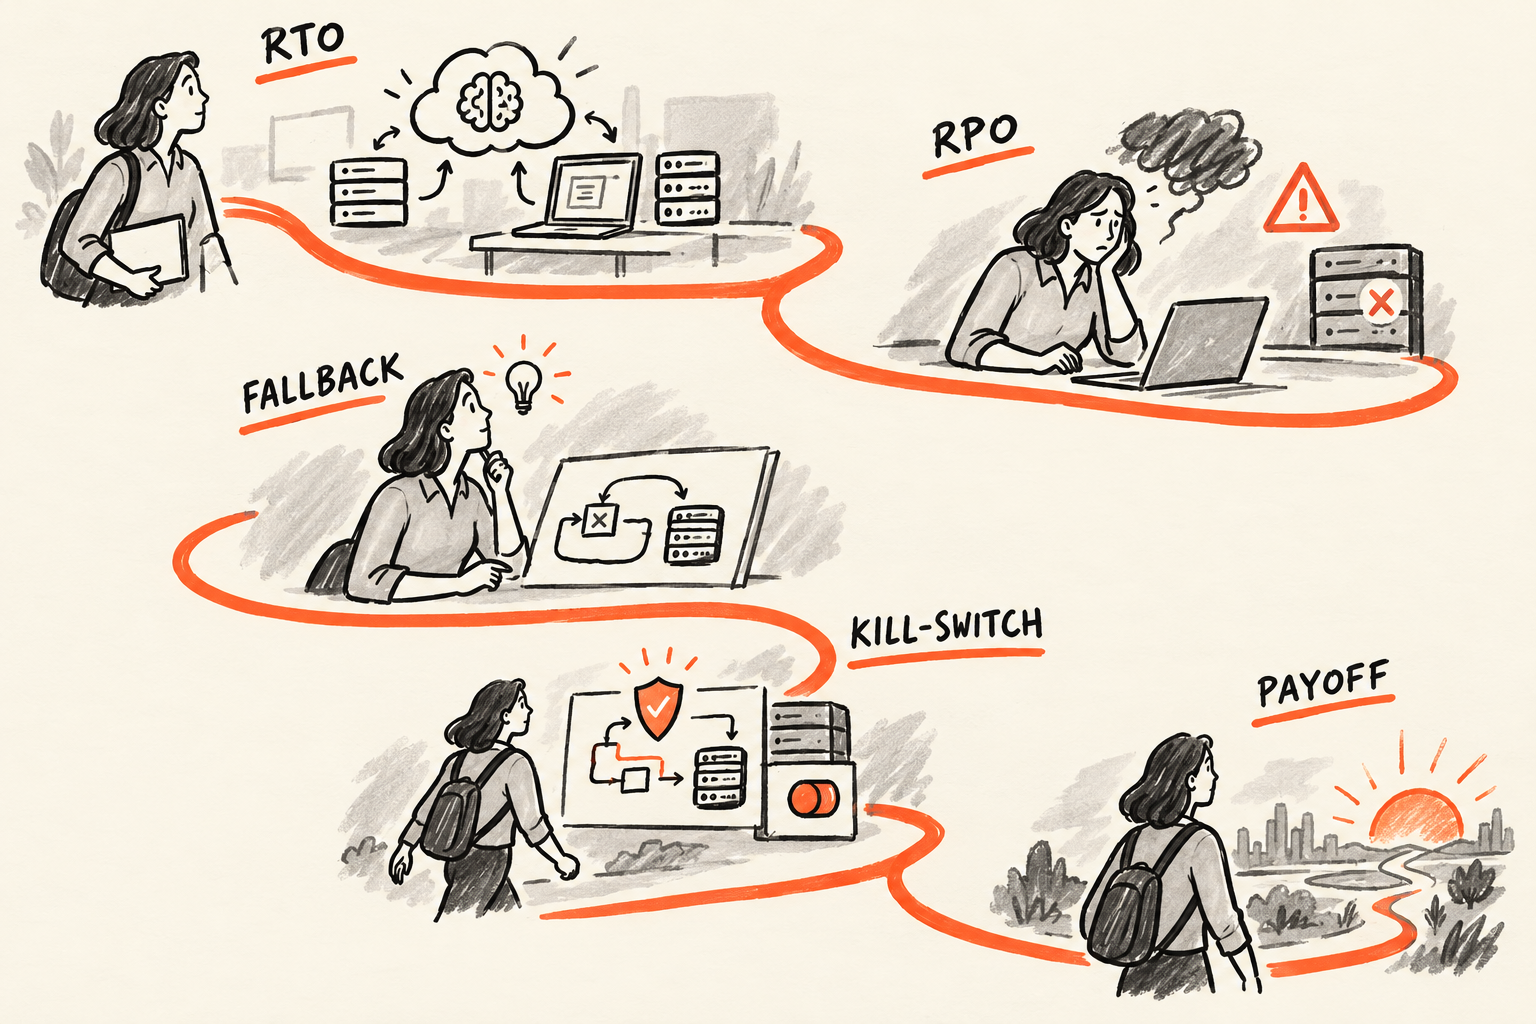
De fleste AI-features bliver shipped, som om de lever uden for de regler, der gælder for produktionssoftware.
Vi taler om prompts, evals og modelvalg. Og så sker det forudsigelige: vendor rate-limiter, policy-laget begynder at blokere en kategori, du er afhængig af, modellens adfærd skifter, eller jeres egen legal-funktion ændrer, hvad “allowed” betyder. Pludselig er AI-sporet væk, og produktets eneste posture er: “Beklager, prøv igen senere.”
Den ubekvemme sandhed er enkel. Hvis AI ligger midt i en omsætningsproces, en supportproces, en reguleret proces eller noget som helst, hvor mennesker venter, skylder du det samme slags continuity-tænkning, som du allerede bruger på payments, identity eller databasen. Ikke de samme metoder, men den samme seriøsitet.
Denne artikel er den manglende runbook: hvordan du definerer RTO og RPO for AI-kapabiliteter, hvordan du designer graceful degradation, og hvornår du skal hard-disable en agent uden at brække workflowet. Den er inspireret af “Building resilient AI-powered software, and planning for when things go wrong”, som med rette trækker disaster recovery-tænkning ind i AI-samtalen.
Start med at navngive den reelle afhængighed: “AI supply chain”
Når en AI-feature fejler, ligger fejlen sjældent ét sted. Den kan være et hvilket som helst led i en kæde:
- Model runtime: latency-spikes, timeouts, kapacitetsgrænser, regionalt outage.
- Vendor contract surface: rate limits, quota-udtømning, prisændringer, deprecations.
- Policy layer: moderation, safety filters, interne governance-gates, krav til data residency.
- Context layer: RAG-index er stalet, embeddings drift, forkerte permissions, manglende dokumenter.
- Tooling layer: en agent kan kalde CRM, ticketing, email, code repo. Hvis bare én af dem er nede, bliver “smart” til “stuck”.
Hvis du behandler “AI” som én afhængighed, skriver du en runbook, der ser pæn ud og fejler i virkeligheden. Runbook’en skal mappe failure modes til bruger-synlige outcomes. Den mapping er hele jobbet.
Gør RTO og RPO eksplicit for AI, også selv om du hader ordene
I klassisk DR er RTO, hvor længe du kan tolerere downtime. RPO er, hvor meget datatab du kan leve med. For AI findes der direkte ækvivalenter, men teams undgår at sætte dem, fordi de blottetlægger produkt-uklarhed.
Her er oversættelsen, der virker i praksis:
- AI-RTO: hvor længe kan den AI-assisterede path være utilgængelig, før du skal flytte brugere over på en alternativ path, der stadig får opgaven afsluttet.
- AI-RPO: hvor meget AI-produceret arbejde har du råd til at miste eller invalidere. Tænk drafts, klassifikationer, summaries, auto-udfyldte felter, forslag til replies, foreslåede code changes.
To regler gør det anvendeligt.
- RTO ejes af forretningsprocessen, ikke engineering-teamet. Hvis AI hjælper med at lukke deals, hvem kan acceptere fire timers outage. Hvis den hjælper med incident-triage, hvem kan acceptere fem minutter.
- RPO handler mest om tillid, ikke storage. Hvis model-output forsvinder, kan brugeren genskabe det. Hvis model-output senere bliver non-compliant, kan I trække det tilbage.
Skriv dette per AI-kapabilitet, ikke per produkt. Jeres “email reply assistant” og jeres “refund decision agent” bør ikke dele samme continuity-target.
Design degradation paths, ikke “downtime pages”
Graceful degradation er ikke en bannertekst med “AI er midlertidigt utilgængelig.” Det er en forudbygget alternativ rute, der stadig færdiggør workflowet.
Jeg bruger tre fallback-modes. Vælg én per kapabilitet, og fortråd skiftet på forhånd.
Mode 1: Assist only, never block
Det er den enkleste posture. AI’en giver forslag, men brugeren kan altid gennemføre opgaven manuelt. Hvis AI fejler, virker produktet stadig, bare langsommere.
- Eksempel: foreslåede ticket-tags, draft release notes, call summary.
- Designkrav: UI’et må ikke afhænge af forslaget for at unlocke næste step.
- Runbook-action: ved fejl skjules AI-affordances, brugerinput bevares, incident logges.
Mode 2: Cached eller replayable results
Nogle opgaver er for dyre eller for langsomme at regenerere, og brugerne accepterer ikke at miste output. Her behandler du AI-output som et beregnet artefakt, der skal persisteres og kunne afspilles igen.
- Eksempel: en lang dokumenttransformation, en analyserapport knyttet til en sag, et sæt ekstraherede felter, der driver downstream-arbejde.
- Designkrav: gem output med provenance (model, prompt template-version, retrieval sources). Det er dit “replay handle.”
- Runbook-action: hvis vendor er nede, servér sidste kendte gode artefakt med en freshness-markering, og queue regenerering.
Mode 3: Deterministic fallback
For visse kapabiliteter kan du erstatte “intelligens” med enklere deterministisk logik, der er dårligere, men sikker.
- Eksempel: routing rules, keyword-baseret klassifikation, templates, statiske decision trees.
- Designkrav: definér den minimum acceptable adfærd, der bevarer compliance og jeres kundeløfter.
- Runbook-action: skift til deterministic mode, når confidence falder, ikke kun når modellen er utilgængelig.
Det centrale executive-spørgsmål er ikke “har vi en fallback.” Det er: hvad er den degraded experience, vi bevidst er villige til at shippe.
Den svære del: når modellen er oppe, men forkert
Traditionel DR er behagelig, fordi outages er binære. AI-fejl er ofte “servicen kører, men svarene er subtilt forkerte.” Det er den incident-klasse, der rammer brand og skaber regulatorisk eksponering.
Du har brug for triggers, der ikke er baseret på uptime:
- Quality regression trigger: eval-scores falder, human review-afvisninger stiger, eller downstream-metrics svinger.
- Policy regression trigger: moderation begynder at blokere legitimt arbejde, eller stopper med at blokere ting, I ikke kan shippe.
- Cost anomaly trigger: token-forbrug per opgave hopper, typisk fordi prompts eller tool calls balloon’er.
Når de triggers fyrer, bør runbook’en ikke sige “undersøg.” Den bør sige “skift mode.” En quality-incident kræver samme beslutsomhed som en security-incident: contain først, analysér bagefter.
En kill switch, der ikke slår forretningen ihjel
Alle teams siger nu, at de har en AI kill switch. Mange af dem er i praksis kun API key-revocation. Det er ikke en kill switch. Det er et outage, du selv har skabt.
En reel kill switch har tre egenskaber:
- Scoped: du kan disable én kapabilitet, én tenant, én geografi, én kanal eller én tool integration uden at slukke hele produktet.
- Reversible: du kan re-enable sikkert med ramp-up (percentage rollout, cohort-baseret gating).
- Workflow-preserving: user path’en kan stadig gennemføres ved at bruge én af degradation-modes ovenfor.
Det er her feature flags, policy-konfiguration og UI-design mødes. Og det er her mange “agentic” projekter falder fra hinanden. De binder en agent ind i en critical path og opdager så, at der ikke findes en sikker mellemtilstand mellem “agent kører” og “workflow dødt.”
Den enkleste måde at undgå det på er at kræve én sætning i design review: “Hvis vi disable’r denne agent kl. 10:00, hvordan afslutter en bruger opgaven kl. 10:01?” Hvis svaret er vagt, har I ikke et produkt. I har en demo.
Runbook-template’en, jeg ville ønske, flere startede med
Du behøver ikke en hundred-siders binder. Du behøver én side per AI-kapabilitet, skrevet i almindeligt sprog, som en on-call person kan eksekvere under pres.
- Capability: hvad AI’en gør (ét verbum). Drafts replies. Extracts fields. Suggests actions. Executes actions.
- Business owner: hvem der beslutter, hvad “acceptable degradation” betyder.
- AI-RTO og AI-RPO: time-to-fallback og hvor meget output-tab der er acceptabelt.
- Dependencies: model vendor, vector store, moderation, tool integrations.
- Failure modes: vendor down, latency, quota, policy block, quality drift, tool failure.
- Fallback mode: assist only, cached, deterministic.
- Kill switch scope: per tenant, per feature, per tool, per geografi.
- User messaging: hvad produktet siger ved degradation. Ingen undskyldninger, kun instruktion og status.
- Data handling: hvad der gemmes, hvor længe, og hvordan I retract’er outputs, hvis nødvendigt.
- Observability: de tre signaler I overvåger (quality, policy, cost) plus latency og error rate.
Én kapabilitet, én side. Hvis det ikke kan være på én side, er designet ikke klar.
En erfaring fra virkeligheden: continuity slår cleverness
Jeg har set en R&D-organisation shippe “smarte” features, der så imponerende ud i et sprint review, men som stille og roligt skabte support-load, fordi produktet ikke havde en degraded mode. Det overraskende var ikke, at modellen opførte sig mærkeligt. Det var, hvor hurtigt teamet normaliserede manuelle heroics for at holde kunderne unblocked.
Det er det, en AI DR-runbook forhindrer. Ikke incidents. Incidents vil ske. Den forhindrer den langsomme accept af kaos som normalt arbejde.
Hvordan det hænger sammen med cost og ownership
Resilience handler ikke kun om uptime. Det handler også om forudsigeligt spend og tydeligt ansvar, når noget går galt. Hvis du vil have finance-siden af samtalen, passer det naturligt sammen med The CFO-Grade Playbook to Prevent Agentic COGS Shock. Hvis du vil have governance-vinklen, så læs AI Sprawl in Danish SMEs Is Not an AI Problem. It’s a Money-and-Risk Ownership Problem.
Holdningen: behandl AI som en tiered dependency, ikke som et magisk lag
AI er ikke specielt, fordi det er intelligent. Det er specielt, fordi det fejler på flere måder, end de fleste teams er vant til, og mange af de fejl ligner succes, indtil en kunde klager.
Hvis du kun gør én ting dette kvartal, så gør dette: Vælg jeres tre vigtigste AI-kapabiliteter og skriv deres runbooks på én side. Sæt eksplicit AI-RTO og AI-RPO på hver. Vælg en degradation mode, der stadig får opgaven i mål. Wire en scoped kill switch, der ikke brick’er workflowet.
Det er sådan, AI bliver sikkert at placere midt i forretningen — ikke kun ude i kanten.
Hvis du vil have et ekstra sæt øjne på jeres AI DR-posture, så ræk ud via kontaktsiden og fortæl mig, hvilke workflows I ikke har råd til at knække.
Nyhedsbrev
Arbejdsnoter direkte i indbakken.
Lejlighedsvise, støjfri noter om ledelse, eksekvering og anvendt AI — fra banen, ikke fra sidelinjen.