29. oktober 2026 · 6 min. læsning
Dit IoT-pilotprojekt fejlede ikke. Det gjorde dine seams.
At skalere connected products handler mest om kontrakt-design og felt-disciplin. Code får bare skylden til sidst.
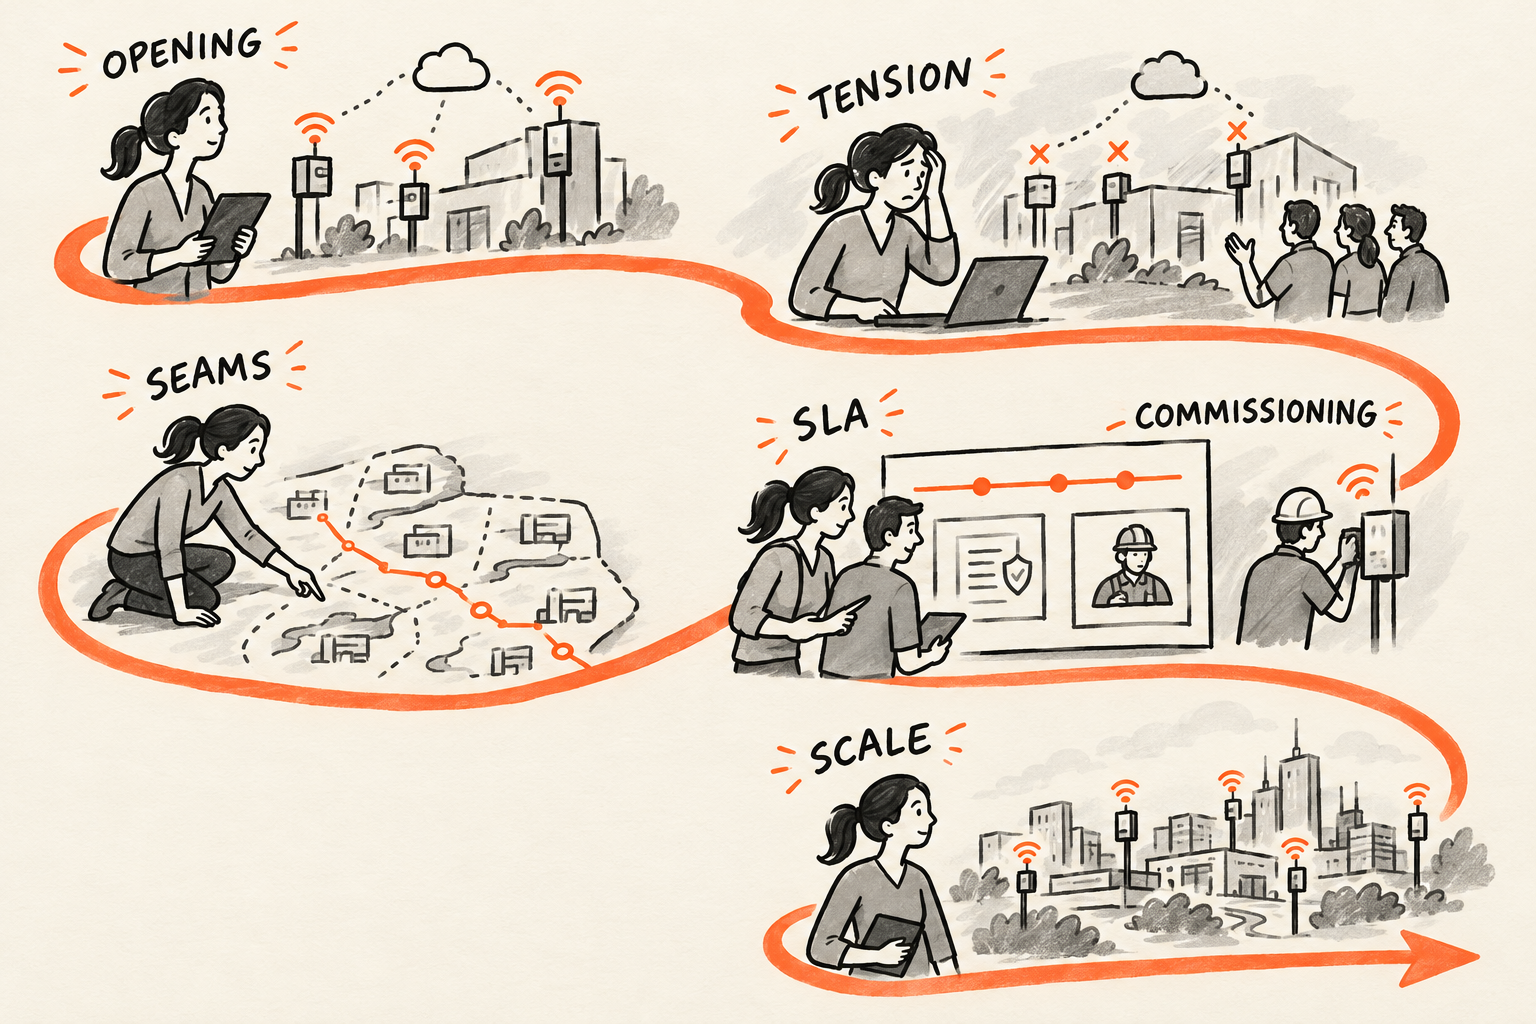
Næsten alle IoT-piloter ser sunde ud i demo-lokalet.
Enheden parres. Dashboardet opdaterer. Et par alerts trigges. Alle nikker, og nogen siger den farlige sætning: “Lad os skalere.”
Så starter den første rigtige rollout, og samme mønster dukker op. Et site har svag connectivity. En enhed skal have en firmware update. En kunde spørger, hvem der ejer uptime. En enhed bliver bricked. Support åbner en ticket, og den hopper mellem “cloud teamet”, “app teamet”, installatøren og hardwareleverandøren. Alle har ret om deres komponent. Kunden er stadig nede.
Derfor rammer denne IoT Now white paper en af de mest gentagelige sandheder i connected products: piloter fejler i seams – ikke i code.
Min overbevisning er enkel: Hvis du ikke kan pege på én ansvarlig owner for commissioning og én ansvarlig owner for kundens end-to-end SLA, så har du endnu ikke et produkt. Du har et forskningsprojekt med fakturaer på.
Seams er der, hvor ejerskab gemmer sig
Når folk siger “IoT er svært”, mener de ofte “det rører for mange teams”. Det er rigtigt, men ikke hele forklaringen. Den reelle failure mode er, at handoffs er udefinerede – eller værre: “shared”. “Shared” er der, hvor deadlines dør.
White paperet peger på de klassiske trykpunkter: ansvar for firmware updates, cloud uptime og data contracts, samt service-modellen når en device bliver bricked i felten. Det er ikke tekniske detaljer. Det er interface-kontrakter mellem mennesker og virksomheder.
Her er den ubehagelige læring, jeg har taget med mig fra at bygge connected building controls: Skalering handler primært om kontrakt-design og felt-disciplin. Tech er sjældent den begrænsende faktor. Den bliver bare syndebukken, når de kommercielle og service-mæssige kanter blev efterladt uklare.
Vil du have en hurtig diagnostic, så stil disse spørgsmål og læg mærke til, hvor hurtigt rummet begynder at forhandle:
- Hvem må pushe en firmware update, og hvem får skylden, hvis det afbryder et site?
- Hvad er cloud-uptime-løftet helt præcist, og er det formuleret i kundesprog eller leverandørsprog?
- Hvem ejer device identity og provisioning, og hvad sker der, når en installatør tager genveje for at nå dagens plan?
- Hvad er feltprocessen, når en enhed bliver bricked, stjålet, byttet – eller bare død?
Hvis et svar starter med “det kommer an på” eller slutter med “det finder vi ud af”, er din pilot ikke klar til at forlade laboratoriet.
Én commissioning owner – ellers bliver hvert site et bespoke projekt
Den dyreste løgn i IoT-skalering er at kalde commissioning for “installation”. Installation lyder som en engangsopgave. Commissioning er et system, der skal vækkes til live i den virkelige verden, under uperfekte forhold, med acceptance criteria der afgør, hvem der får betaling – og hvem der bliver straffet.
White paperets mest praktiske pointe er den, jeg ville ønske flere teams tog alvorligt: udpeg én commissioning owner med autoritet på tværs af installatør, connectivity, device identity og acceptance criteria. Uden det bliver hver deployment til et custom projekt, og din margin forsvinder i rejser, rework og eskalationer.
Denne person er ikke en projektleder med en pæn Gantt-plan. De skal have mandat til at sige:
- “Vi accepterer ikke dette site, fordi connectivity ikke lever op til minimum.”
- “Vi går ikke live, før provisioning er automatiseret og sporbar.”
- “Det her er acceptance tests, og vi kører dem ens alle steder.”
Når commissioning er svag, bliver din rollout en samling undtagelser. Undtagelser formerer sig. Så bliver engineering trukket ind i field firefighting, og roadmap’et ender som en kirkegård.
Som mental model: Behandl commissioning som en product surface – ikke en delivery-opgave. Det kræver en spec, et toolchain og en single throat to choke.
Beslutningen der stopper software i at blive syndebuk
Hvis jeg kunne tvinge én beslutning igennem før enhver rollout, var det denne: Definér skriftligt, hvem der ejer kundens end-to-end SLA.
White paperet siger det uden omsvøb: definér ikke ejerskab efter komponenter. At sige “cloud uptime ligger hos platform teamet” og “device reliability ligger hos hardwareleverandøren” lyder ryddeligt. I praksis respekterer incidents ikke org charts.
De fleste downtime-historier i connected products ser sådan ud:
- Enheden er ok, men kan ikke nå cloud’en pga. en ændring i sitets netværk.
- Cloud’en er ok, men device-certifikater udløb pga. et oversight i lifecycle.
- App’en er ok, men en firmware update introducerede en sjælden boot loop i felten.
Hver komponent-ejer har et argument. Systemet fejler stadig den person, der betaler for det.
En end-to-end SLA owner ændrer samtalen fra “hvem har ret” til “hvad genskaber service hurtigst”. Det tvinger også de rigtige engineering-valg opstrøms: observability, rollback paths, staged rollouts og det kedelige arbejde, der forebygger incidents på flere dage.
Hvis du har drevet en seriøs service, kender du punchlinen: Kunder køber ikke din arkitektur. De køber resultatet – og din respons, når det går i stykker.
En kill-or-scale checklist, der faktisk forhindrer rollout-teater
Piloter dør ofte langsomt, fordi ingen vil sige “stop”. Så bliver de permanente: et par sites, masser af opmærksomhed og lige nok succes til at holde håbet i live.
Jeg foretrækker en skarpere gaffel: kill it eller scale it. White paperet peger på samme medicin: brug en checklist, der tvinger ejerskab frem.
Her er den version, jeg ville lægge foran et leadership team. Hvis I ikke kan svare, så ruller I ikke ud. Ikke fordi tech’en er dårlig – men fordi I er ved at bygge en support-katastrofe.
1) Seam map (skriv det ned)
- Firmware: hvem kan deploye, hvordan I stage’r, hvordan I ruller tilbage, hvem der godkender emergency patches.
- Cloud: uptime-mål, maintenance windows, data retention, data access, incident comms.
- Identity: provisioning flow, certificate rotation, proces for replacement device.
- Field service: hvem udskifter hardware, lead times, hvad der er billable, hvad der er warranty.
Hvis en seam er “shared”, så fix den. “Shared” betyder, at ingen er accountable, når det gør ondt.
2) Commissioning authority (ét navn)
- De ejer acceptance criteria og commissioning playbook.
- De kan blokere et go-live, når prerequisites ikke er opfyldt.
- De styrer installer-interfacet, inkl. træning og audit.
3) End-to-end SLA (én owner)
- Én eskalationsvej for kunden.
- Én incident commander ved priority outages.
- Tydelige interne contracts med hvert component team eller supplier.
4) De grimme cases (beslut før de sker)
- Hvad gør I, når en enhed bliver bricked?
- Hvad gør I, når connectivity er ustabil?
- Hvad gør I, når en installatør afviger fra standarden?
- Hvad gør I, når kunden nægter en firmware update?
Det her er ikke edge cases. Det er tirsdag.
5) En scaling trigger (ikke mavefornemmelse)
- Definér, hvad “pilot-succes” betyder i målbare termer: stabilitet, repeatable commissioning time, support load og uptime.
- Vælg tærsklen, der udløser rollout-investering – og tærsklen, der lukker programmet.
Det er her, de fleste teams snyder. De tager en demo som bevis. Dit eneste bevis er repeatability under normale feltforhold.
Min holdning: IoT er en serviceforretning, der udgiver sig for at være en produktforretning
Connected products står ude i verden. Verden er rodet. Det rod skal prissættes, kontraktligt afklares og supporteres.
Så ja, software betyder noget. Men software er ikke din største risiko. Din største risiko er at shippe noget, der ikke kan commissiones konsistent, ikke kan opdateres sikkert, og ikke har et klart end-to-end løfte til kunden.
Hvis du kun tager én ting med: Før du skalerer, så gå på seam-jagt. Sæt en owner på hver seam. Sæt derefter én owner over dem, der er accountable for kundens outcome.
Sådan stopper du piloter i at dø høfligt. Og sådan bygger du teknologi, der ændrer noget reelt for de mennesker, der lever med den.
Hvis du netop nu er på vej fra pilot-sites til egentlig rollout, kan det også hjælpe at læse Autonomy’s Hard Part Isn’t the Car. It’s the Service. Problemet har samme form: Det svære er det, der sker efter demoen.
Nyhedsbrev
Arbejdsnoter direkte i indbakken.
Lejlighedsvise, støjfri noter indefra arbejdet: hvad der blev leveret, hvad der gik galt, og hvad jeg ville gøre anderledes.